干得漂亮!中国与美国差距进一步缩小!10月6日,多家外媒援引彭博社智库的新近报告称,随着中国人工智能实验室逐渐迎头赶上,美国AI企业对中国的领先优势在过去几个月来已经呈现大幅收窄趋势、降至历来的新低,譬如,今年9月期间,中国顶尖AI模型在权威基准测试中的得分仅落后于美国有关对手3%。
一场科技竞争最让领先者难受的,不是对手忽然拿出一款厉害的产品,而是自己投入越来越多的钱,原先建立的优势却越来越很难维持。当下的人工智能行业,正在显现这种改变。美国科技企业仍然掌握不少核心资源,但中国模型的进步速度,已经让美国过去那套依靠算力和资本拉开距离的办法面临考验。
先看一笔账。美国大型科技公司建设AI数据中心,动辄投入数百亿美元,还要采购昂贵的英伟达GPU,承担巨额电力和维护费用。中国企业没有完全照着这条路线走,而是更加重视模型架构、训练效率和推理成本。两种发展方式正在接受市场检验,谁花的钱更多,已经不能直接决定谁的产品更有竞争力。
2026年8月19日,彭博社发表中美人工智能竞争专题报道,指出中国模型不仅在技术能力上快速接近美国,在使用成本和全球推广方面也取得了明显进展。报道特别关注月之暗面的KimiK3,认为其部分能力已经接近Anthropic的先进模型。对于长期认为美国会持续扩大领先优势的人来说,这无疑是一个值得重新审视的信号。
为什么中国企业能够追得这么快?一个重要原因是,人工智能研发并不是单纯比拼芯片数量。模型参数如何组织、训练数据怎样筛选、推理过程如何优化,都可能产生巨大影响。同样一项任务,有的模型需要消耗大量计算资源,有的通过改进算法就能减少开销。中国研发团队正在把工程优化变成实实在在的竞争能力。
回顾2025年初,DeepSeek-R1曾经让全球科技市场重新认识中国人工智能。当时引发关注的,不只是模型本身的推理表现,还有它对传统研发成本逻辑的冲击。过去,外界习惯把巨额投入视为先进模型的必要条件。DeepSeek证明,高水平算法研究和系统优化同样能够带来突破,也让更多企业开始认真研究中国技术路线。
进入2026年,这种影响已经从一家企业扩展到整个行业。阿里巴巴的通义千问、智谱的GLM、MiniMax以及月之暗面的Kimi,都在不同应用方向展开竞争。中国AI产业不再依靠个别产品制造短期轰动,而是形成了多家企业持续迭代的局面。竞争越充分,模型改进的压力越大,开发者能够获得的选择也越丰富。
真正让美国企业感到压力的,是中国模型开始影响海外开发者的选择。彭博社8月报道显示,在OpenRouter平台,中国模型6月的使用份额首次超过美国模型,7月进一步突破60%。HuggingFace平台上,中国生成式模型的下载占比也达到41.4%。这些只是特定平台的数据,却足以说明中国模型正在获得更多国际关注。
这种变化对美国AI公司的商业模式构成了直接挑战。过去,先进模型数量有限,用户想获得更好的性能,就需要接受较高的调用价格。现在,中国企业提供了更多性能接近、成本更低的选择。对于每天需要处理海量请求的软件公司来说,哪怕单次调用费用只降低一点,长期累积也可能节省大量开支。
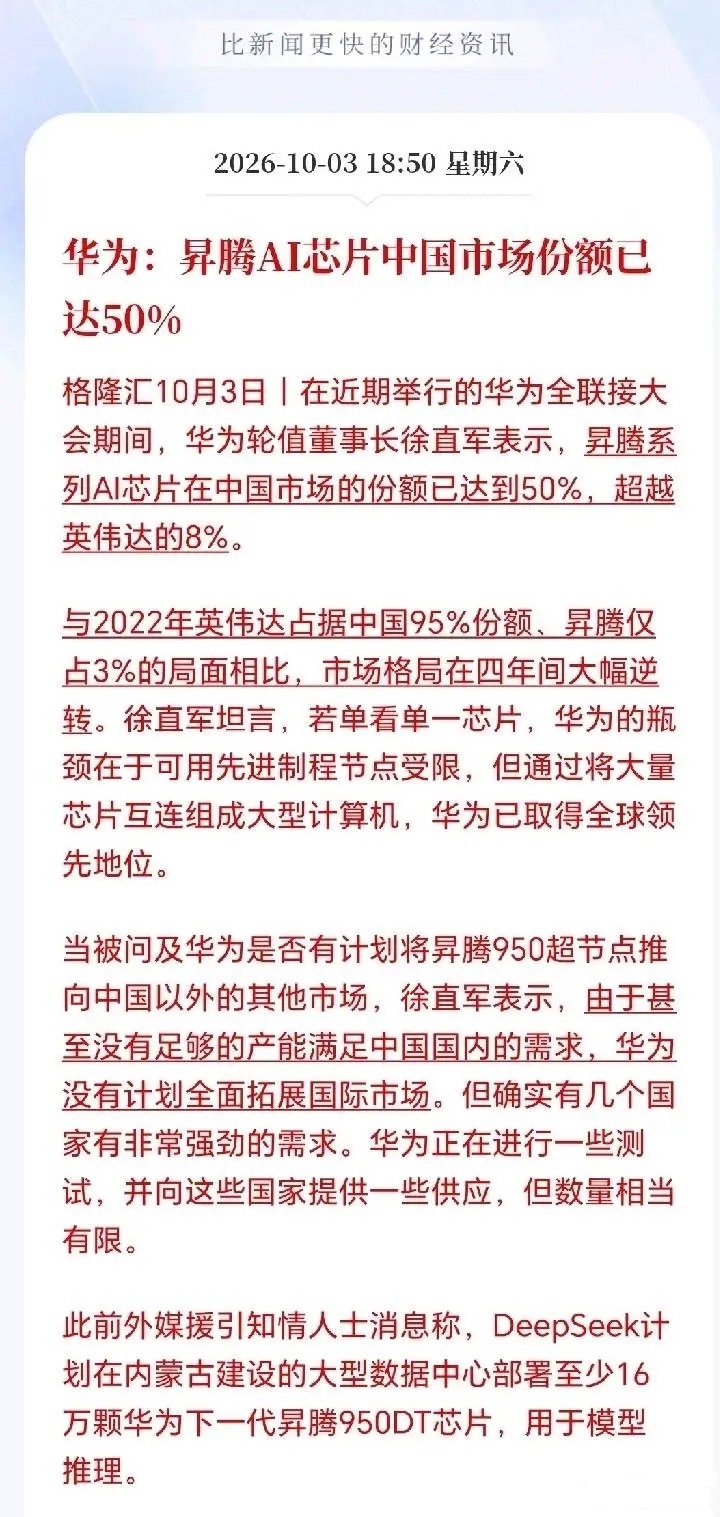
9月4日,彭博社报道,DeepSeek计划在内蒙古建设的数据中心部署至少16万颗华为昇腾950DT加速器。报道援引知情人士消息称,相关部署时间仍取决于芯片供应情况,而且这些芯片主要计划用于模型运行,并非已经全面承担先进模型训练。消息尚不能当作完成部署的事实,但它揭示了国产算力生态正在争取的重要应用机会。
这件事的意义远不止采购多少芯片。美国在人工智能基础设施上的优势,不只有英伟达硬件,还有围绕CUDA建立起来的软件工具和开发者习惯。中国如果想形成稳定的自主技术体系,就必须让国产芯片、计算框架和模型之间实现高效配合。只有开发成本降下来、系统稳定性提上去,国产算力才能真正获得大规模使用。