老黄可能怎么也没想到,自己筑了二十年的CUDA高墙,会被一家年轻的中国大模型公司用最干脆的方式给拆了墙角。
国庆前夕,DeepSeek做了一个让硅谷摸不着头脑的决定:把面向华为昇腾芯片的一整套开发工具和底层高性能算子,直接开源了。
CUDA这堵墙是怎么筑起来的?英伟达花了将近二十年,让全球四百万开发者习惯了一件事:想让AI芯片跑起来,就得用CUDA写代码。
代码写完了,就跟英伟达的硬件焊死了,想换别的芯片,得从头再来一遍。硬件指标再好看,迁移成本这道坎跨不过去,企业就只能继续用英伟达。这堵墙不是靠芯片性能堆出来的,是靠开发者习惯和代码存量堆出来的。
DeepSeek这次的动作,核心不是发了什么新芯片,而是把拆墙的工具直接交给了所有人。
开源的内容包括TileLang高级语言编译工具、计算库、分布式通信库,全部与之前面向英伟达平台的版本一一对应。
说的直白一点,就是DeepSeek训练大模型用的那些底层计算程序,现在在昇腾芯片上全都有了对应的高性能版本。
TileLang是北京大学计算机学院团队主导开发的一门编程语言,2025年1月开源。它的设计目标很明确:建立新一代自主可控的GPU软件生态,首先得有一个通用的、编程简单的、同时能达到硬件性能上限的高级语言。
跟CUDA比,TileLang写起来更简单,代码逻辑更简洁;跟其他同类高级语言比,它能更充分地发挥芯片本身的性能,逼近硬件的上限。
更关键的一点是,TileLang不跟特定硬件绑定。只要芯片厂商完成一次底层对接,基于TileLang写的程序就能直接在这款芯片上跑。迁移成本从“每个企业都得重写全部代码”,变成了“芯片厂商做一次适配就行了”。
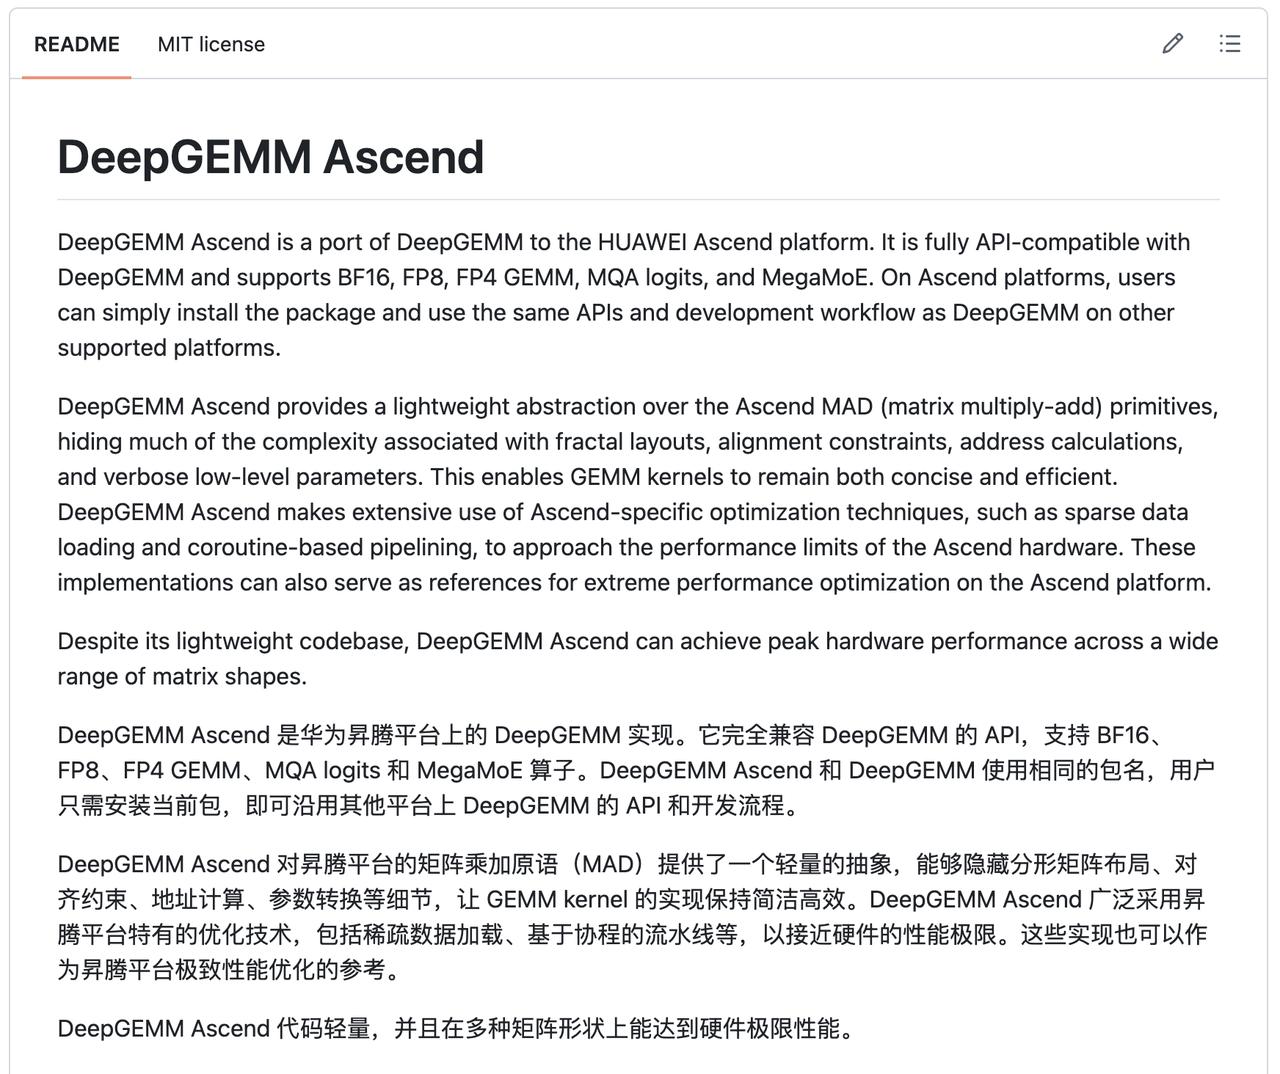
这次开源还包括五个核心组件:DeepGEMM负责矩阵运算加速,DeepEP负责跨设备通信,TileKernels处理常规向量计算和访存,FlashMLA优化长上下文处理的稀疏注意力算子,DeepSelect实现高效数据筛选。
在多项关键测试中,这些组件的计算和通信性能已经接近硬件的理论极限。面向昇腾950的稀疏注意力算子,在读取输入阶段达到410 TFlops,是硬件极限的95%;生成阶段达到360 TFlops,是极限的83%。
DeepSeek在公告里说得很清楚,训练中用到的每一个TileLang算子,在昇腾上都有对应的高性能实现。华为团队在整个过程中给了毫无保留的支持,双方共同推进了基于昇腾950的128卡超节点方案,对计算和通信做了深度优化。
但这事要客观看。DeepSeek目前仍然在使用英伟达芯片做模型训练,华为昇腾芯片主要用在推理环节。开源工具让昇腾在软件栈层面具备了承接前沿模型训练的能力,不等于说训练已经全面迁移过去了。
软件工具链打通了,硬件产能、集群规模、实际训练效率这些还需要时间验证。华为自己也说了,因为国内需求都还满足不过来,昇腾芯片目前限制了海外销售。
从产业角度看,这次开源释放的信号比具体的技术指标更重要。长期以来,中国大模型的研发高度依赖英伟达的GPU和CUDA生态,国产芯片更多是“可用”的备份选项。现在DeepSeek把训练环节的软件栈打开,把迁移的门槛从企业侧挪到了芯片厂商侧。
国产芯片厂商只要完成一次底层适配,就能接住前沿大模型的训练需求。
民生证券指出,华为昇腾已经针对TileLang语言启动了核心算子开发,国产AI芯片正在拥抱由本土AI应用催生的新软件标准,逐步构建一个不完全依赖CUDA的生态系统。中信证券预计,随着智能体和多模态应用的爆发,2026年国产算力芯片出货量至少翻倍。
中国移动北京分公司联合移动云公司已经宣布,华为昇腾950DT千卡超节点正式落地昌平数据中心,单节点1024卡算力达到1 EFLOPS。
黄仁勋之前就说过,如果DeepSeek的最新一代大模型率先在华为先进芯片平台上发布并全面适配,对美国在全球人工智能领域的战略地位将是一个灾难性的打击。
他真正担心的不是某一款芯片的算力参数,而是CUDA这道软件壁垒被从根子上绕过去了。
我的判断是,这次开源是国产AI算力软件生态的一次关键补课,但补的是“软件栈能不能跑”这一课,不是“训练已经全面替代”这一课。CUDA用了二十年积累的开发者习惯和代码存量,不是一次开源就能抹平的。
DeepSeek把工具给了出来,路铺好了,接下来要看的是华为的芯片产能能不能跟上,国产超节点的实际训练效率能不能经得起检验,以及更多开发者和企业愿不愿意把项目搬到这条新路上来。工具开源只是第一步,真正的考验在后面。