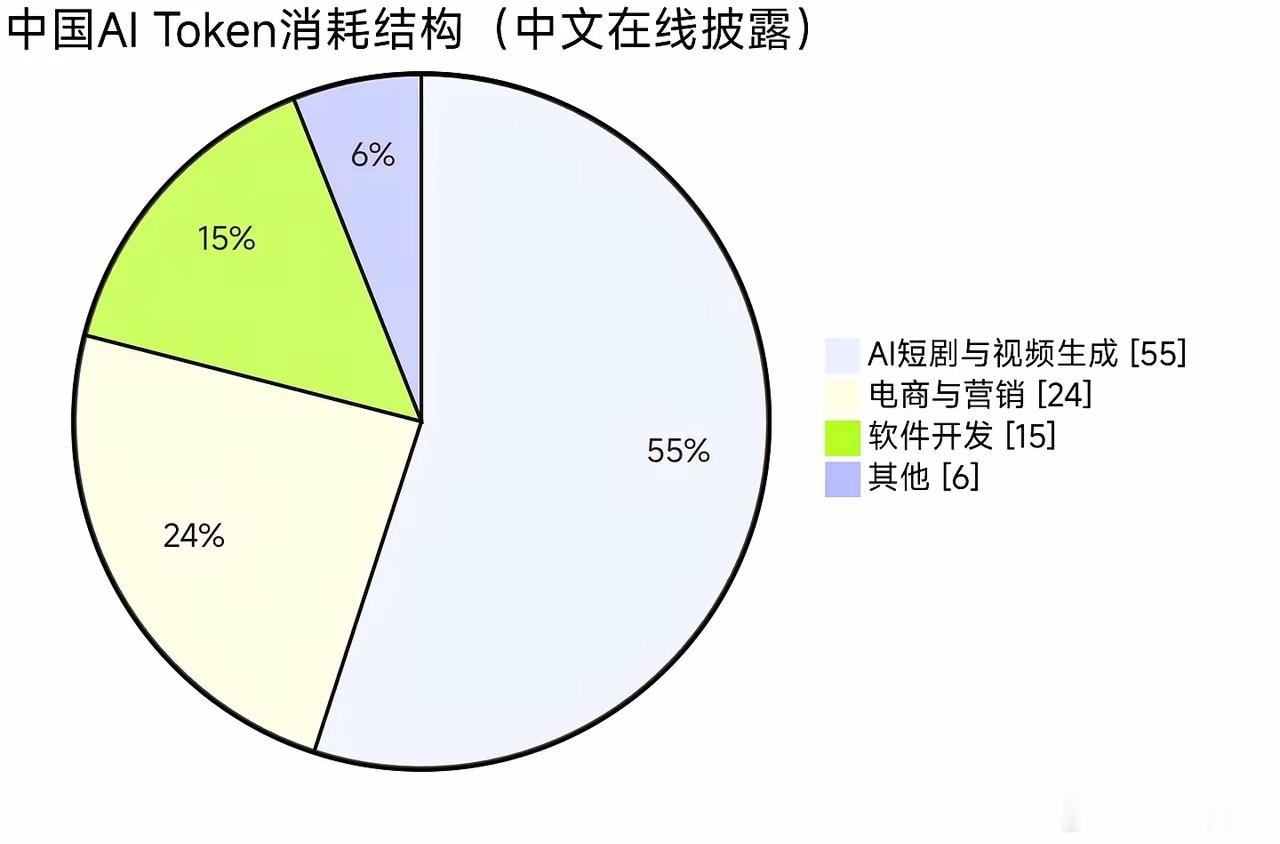
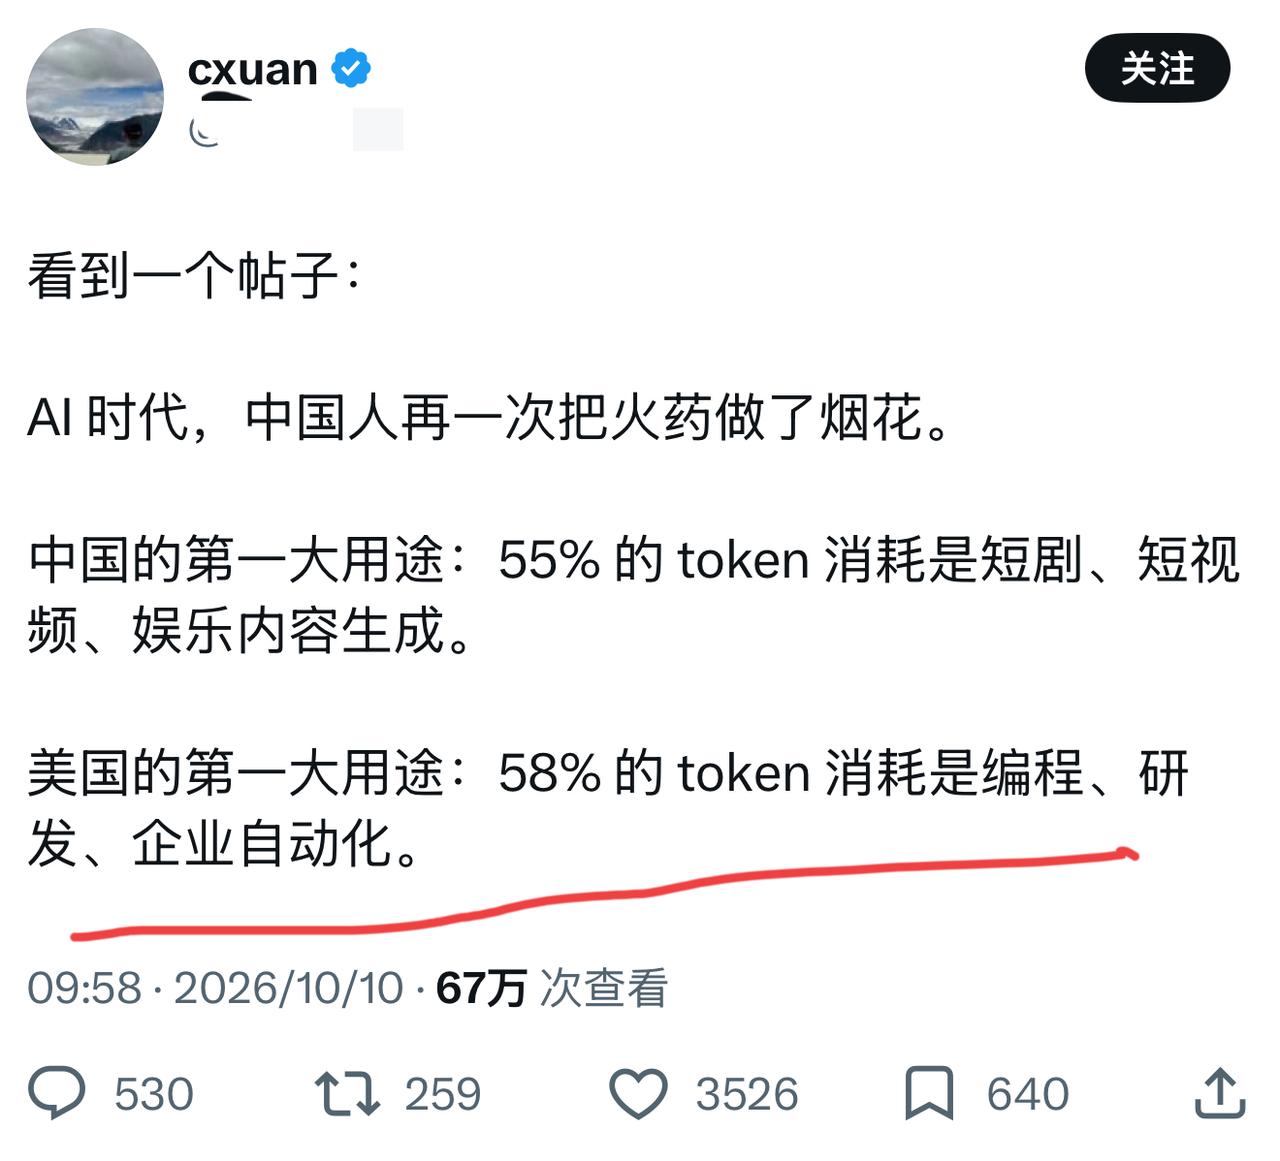
网传的“中国55%的AI算力在做短剧,美国58%的AI算力在做代码”这个说法,不少人立马开始抬高美国、贬低中国。
中文在线今年6月发过一份材料,里面写着国内AI相关的使用量中,短剧和视频生成占了55%,卖货和广告占24%,写代码只占15%。
一家做短剧的公司,拿出一份数据说自己是第一名,这话本身没毛病。但问题在于,这份材料统计的根本不是算力。
打个最直白的比方,你去饭店吃饭,点了一碗面,这碗面用了多少面粉,跟后厨灶台烧了多少煤气,是两码事。
AI这边,“用了多少面粉”叫调用量,就是你每让AI帮你写段话、生成张图,它就得处理一次信息,次数多了数字就大。
视频生成这玩意儿特别吃调用量,生成一帧画面就得处理海量信息,一分钟短片下来,那个数字能大得吓人。但“烧了多少煤气”叫算力,是显卡实实在在跑了多长时间。
视频生成是调用量大,写代码是单次跑得久,两者完全不是一个赛道上的事。调用量大,只能说明用的人多、生成的次数多,推不出“全国一半以上的显卡都在干这个”。
更关键的是,这份材料只统计了公有云上的调用情况,也就是中小客户和普通用户在云端调接口的那部分。
国内真正吃算力的大头根本不走这条路。大模型的训练、科学计算、工厂里的仿真模拟,全是企业和机构自己建机房、自己买卡来跑,不对外卖调用量,自然也不会出现在那份材料里。
工信部公布的数据摆着:到今年6月底,国内智能算力规模达到2185百亿亿次,围绕算力枢纽建了70多条大通道,同比增长177%。
全国首个全国产十万卡超集群曙光8000已经正式投用,接入国家超算互联网,核心节点完成了300多项应用适配,覆盖大模型研发、生物医药、新材料、气象等20多个领域。
IDC的调研数据也显示,已经用上大模型和智能体的中国工业企业比例,从2024年的不到一成,一年之内涨到了47.5%,翻了将近五倍。这些东西不生成短剧,也不产卖货脚本,但它们真实存在,而且规模不小。
再说美国那58%。我把能翻的公开报告都翻了,斯坦福的AI指数报告、摩根大通的研究、国际货币基金组织的分析,没有任何一家机构发布过“美国AI算力按用途拆分”的数据。
这个数字大概率是某些博主为了对比效果编出来的。唯一能沾上边的是风投机构Menlo Ventures对企业AI支出的调查,里面说编程占企业部门级AI支出的55%左右。
但那是企业花钱买AI服务的用途分布,跟“全美算力”完全是两码事。美国自己的普通用户用AI聊天、刷社交平台,那些算力消耗没人单独拎出来算过。
这两个数字搁一起,最要命的是分母对不上。国内那个55%讲的是公有云上普通用户的调用量,美国那个58%拿的是企业付费支出的用途分布。一个算奶茶店卖了多少杯,一个算公司买了多少办公用品,硬凑成一张表,结论从根上就不成立。
更何况,美国那些AI平台的收入里,大量调用量是中国程序员和全球开发者贡献的,活干在中国的项目上,账记在美国平台头上,把全球用量全算成“美国在搞研发”,这账算得太粗了。
传言的另一半假,不是数字假,是逻辑假。它预设了一个前提:做短剧就是低端,写代码就是高端。
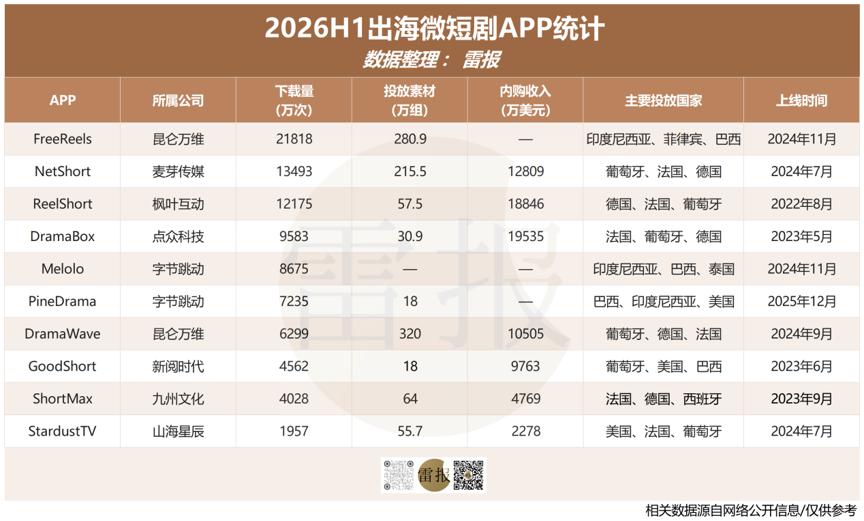
可中国微短剧已经跑出了实实在在的规模,海外市场九成以上是中国企业的。视频生成模型练出来的视觉能力,反哺到自动驾驶和工业检测上也不是新鲜事。
说白了,中美AI用在哪里,本质是两边的市场土壤不一样。中国刷短视频、逛电商的人多,AI先在这些地方跑通了赚钱的路子,再往工业和科研渗透,这是务实的打法。
美国企业数字化起步早,公司愿意花钱买AI工具,写代码和企业助手先收上钱来,再往普通人这边延伸。两条路,起点不同而已。
邬贺铨院士今年9月公开讲过一组数据,中国训练用的算力大概占四成,推理用的占六成。推理算力的大头正在往工厂和产业场景走,工业仿真、智能研发、生产运维的算力增速已经超过了内容创作。
公有云上短剧的热闹是水面上的浪花,水面底下,工业和科研算力的规模早就在那儿摆着了。