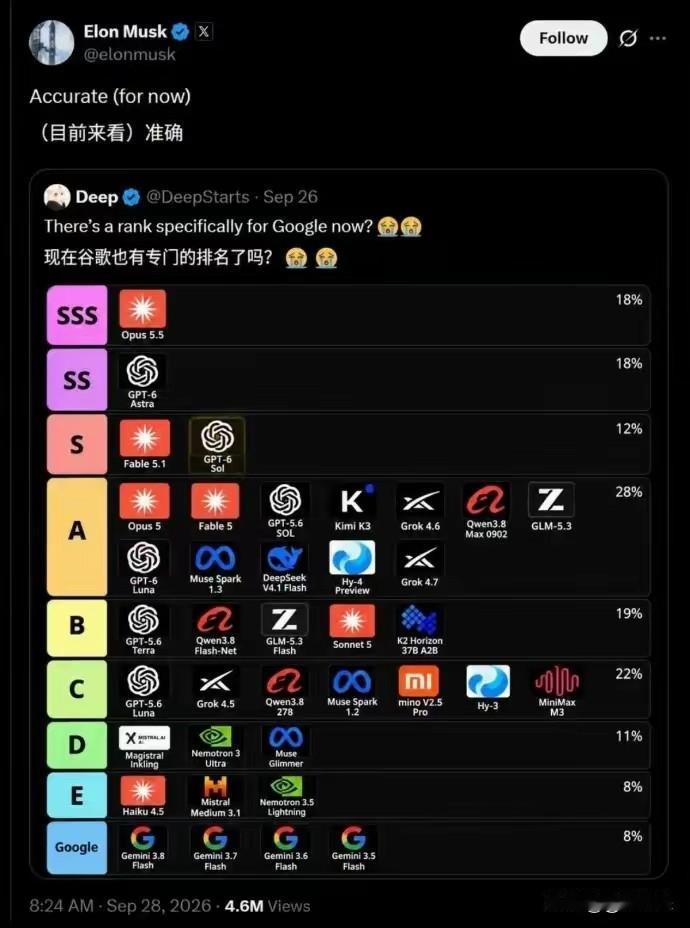
Kimi K3 王者,之前编码智普口碑不错,这一轮 Kimi 太屌了!
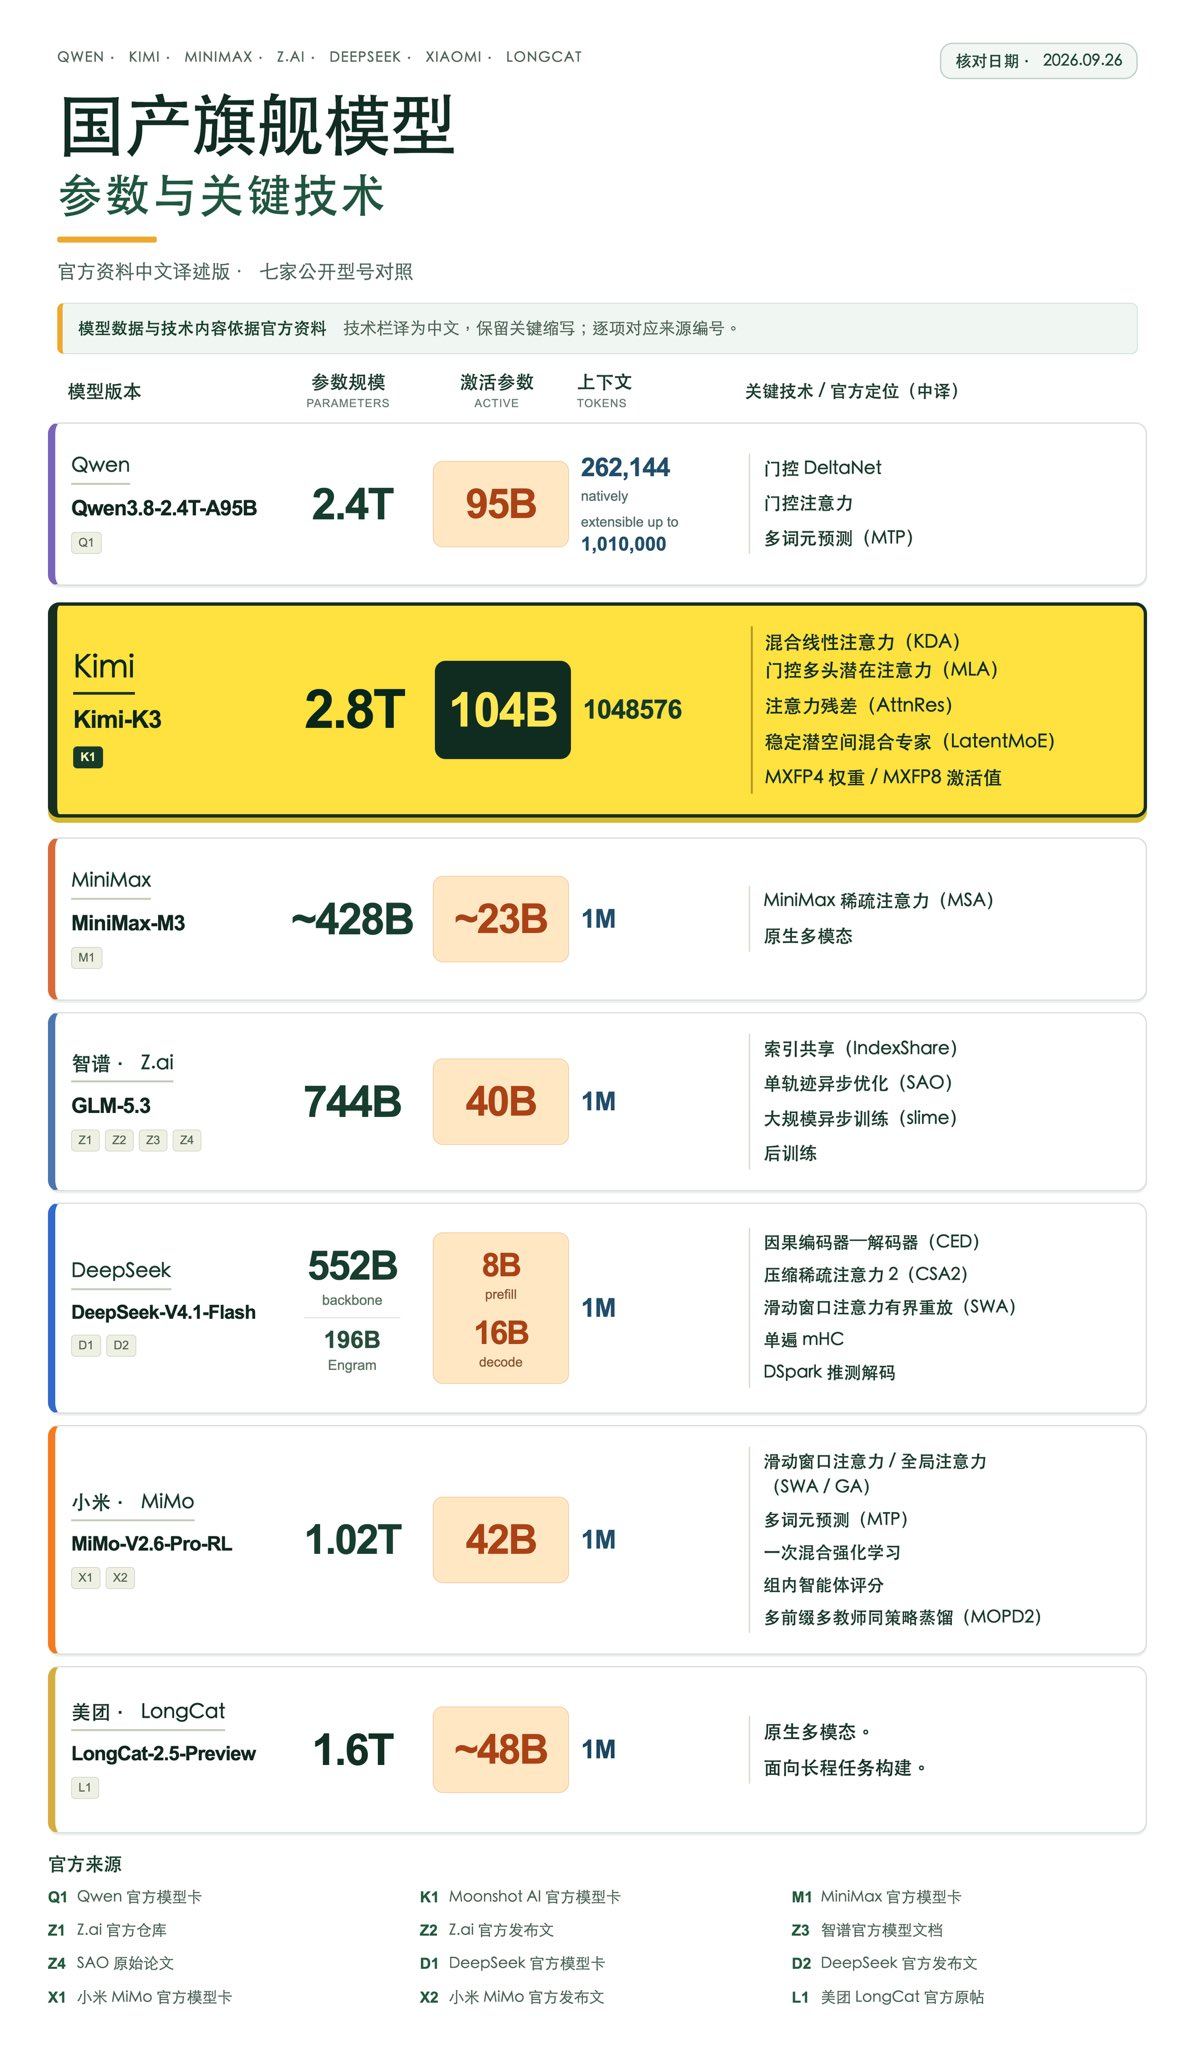
1M 上下文作为前沿模型门槛,我把 Qwen、Kimi、MiniMax、GLM、DeepSeek、MiMo 和 LongCat 摆在一张图里,看看他们的技术路线。
这一张参数表,其实是对同一个问题下卷出了不一样的解法:怎样让更大的模型,用更少的激活参数、更长的上下文和更低的推理成本完成任务。
最抢眼的是 Kimi-K3,2.8T 总参数、104B 激活参数,规模直接拉到这一组最高。Qwen3.8 是 2.4T/95B,LongCat 1.6T/~48B,小米 MiMo 也到了 1.02T/42B。MiniMax-M3 只有约 428B,却把激活参数压到约 23B。DeepSeek-V4.1-Flash 的设计更激进,552B backbone 加 196B Engram,prefill 和 decode 分别只激活 8B、16B。
七家基本都把上下文推到 1M 左右,注意力方案却开始疯狂分叉:Kimi 用 KDA、AttnRes ;Qwen 走 DeltaNet 与门控注意力;MiniMax 有 MSA;智谱做 IndexShare 和 SAO;小米组合 SWA/GA、MTP、一次混合强化学习与 MoPD2;DeepSeek 继续拆分编码、注意力和推理解码。
总参数已经不能直接告诉你模型跑起来到底多贵、多快。真正影响推理账单和吞吐量的,是每个 Token 实际激活多少参数,以及注意力、记忆和解码链路怎么设计。
以后做模型选型,盯着“多少万亿参数”已经不够了。激活参数、上下文、注意力结构、训练方法和部署成本,最好一起看。