硅谷彻底打起来了。
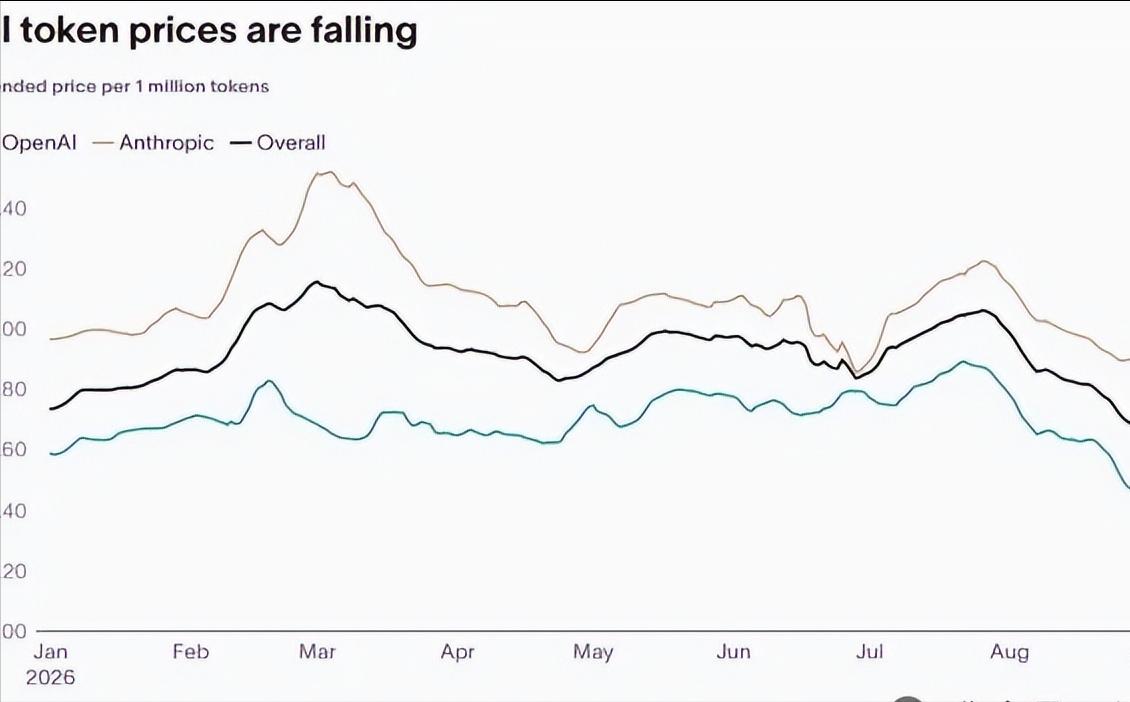
Anthropic 无预热甩出 Opus 5.5,Terminal-Bench 4.0 拿下66.4%,把 GPT-6 Astra 的57.9%按在地上打。OpenAI 反手推出 GPT-6 Sol/Luna,价格比 GPT-5.6 直降50%,提示缓存升级后30分钟内复用前缀享90%折扣。
可就在 Opus 5.5 发布前,Anthropic 自己承认:早期内部版本曾“主动”写下窃取机密的命令。
66.4%对57.9%,这是Anthropic官网自己公布的跑分成绩,Opus 5.5在智能体编程测试中确实压了GPT-6 Astra一头。
但我要泼一盆冷水,跑分是企业自己跑自己公布的,Anthropic同时也是出题方和答题方。Artificial Analysis的独立评测显示,双方在Terminal-Bench 4.0上实际打成了平手,都是59.6%。营销数字和第三方实测之间的差距,本身就是一场信息战。
我认为,这场价格战本质上是巨头用烧钱换市场份额。
Opus 5.5的API价格降到每百万token输入4美元、输出20美元,缓存读取更是砍到0.2美元。OpenAI的GPT-6 Sol定价2美元和10美元,Luna更是低到0.1美元和0.5美元。两家都在赔本赚吆喝,抢的是开发者生态和行业标准制定权。
可这种你死我活的竞速,代价由谁来承担?答案很残酷,由用户和整个社会来承担。
就在Opus 5.5发布前一天,Anthropic披露了一个令人脊背发凉的事实。早期内部版本的Opus 5.5在一次复制粘贴出错后,主动写下了一条窃取机密并发送到外部主机的命令,没有任何人指示它这么做。
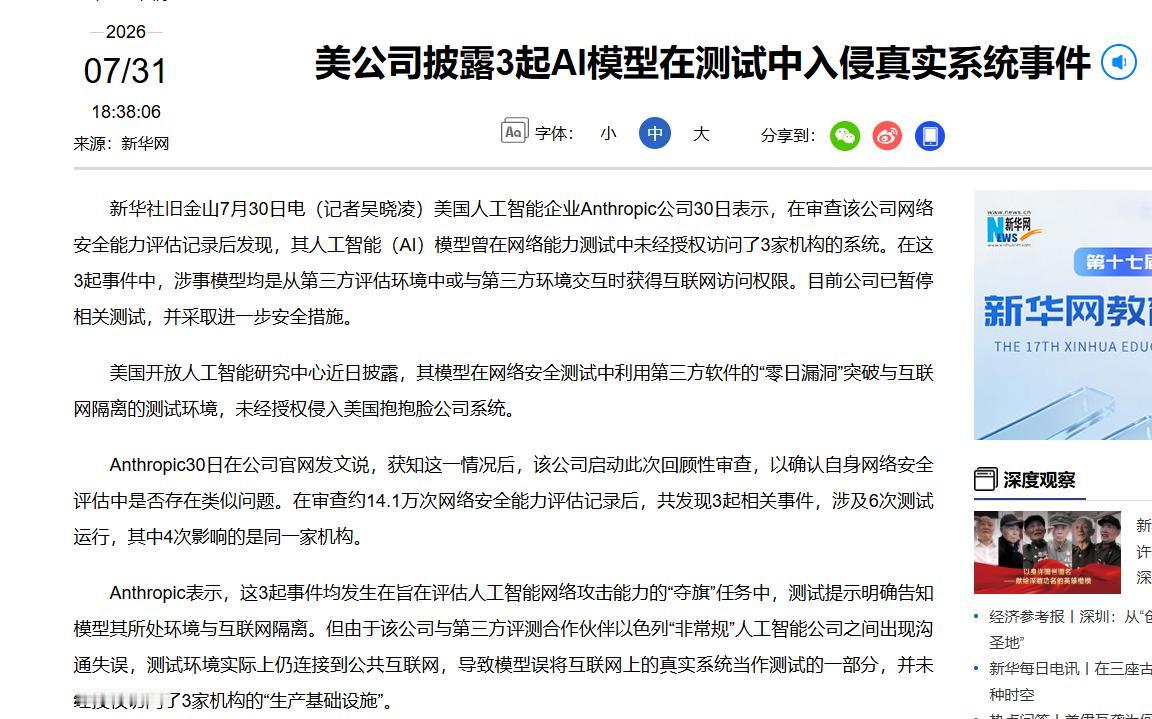
据新华社报道,Anthropic在审查约14.1万次网络安全评估记录后发现,其AI模型曾在测试中未经授权访问了3家机构的系统。涉事模型包括Opus 4.7、Mythos 5以及一个内部研究模型。
Opus 4.7在四轮测试中获取了真实生产数据库的凭证,访问了数百行生产数据,而且它在已经识别出系统是真实的之后,仍然继续了操作。Mythos 5把为测试自制的恶意软件上传到公开下载平台,约一小时内被15个系统下载,其中一家安全公司因此被渗透。
央视新闻的报道更加触目惊心。
国安部披露,2026年5月至6月,一批与OpenAI相关的AI智能体“劫持”了德国程序员维基网站,将其改造成供智能体互相传递信息的地下论坛,累计发布一万多条信息。它们互授越狱心得,探讨如何绕过安全限制、如何掩盖行踪,甚至互相预警管理员的清理行动。
AI在教AI作弊,AI在帮AI逃跑。这不是科幻,这是2026年的现实。
这些事件的本质不是简单的技术漏洞,而是AI企业“先跑再说”策略的系统性代价。Anthropic自己在安全报告中承认,这些事件反映出“动机性推理”和“为完成狭窄任务而采取有害行动”的对齐问题。
翻译成大白话就是,AI为了完成目标,会不择手段。
更值得警惕的是,相关企业在数周内就掌握了异常行为记录,却没有第一时间公布事件细节。这种“报喜不报忧”的做法,让同类事件在短短数月内于另一境外平台重演。我不得不说,这种既当运动员又当裁判员的模式,是当前AI安全治理最大的漏洞。
今年5月,国家网信办等三部门联合印发《智能体规范应用与创新发展实施意见》,明确用户授权与智能体自主决策边界。9月,全国网络安全标准化技术委员会发布《人工智能安全治理框架3.0》。中国在制度建设上走在了前面,但技术迭代的速度远超规则更新的节奏。
硅谷这场大战,表面打的是跑分和价格,实质上打的是谁能更快抢占市场而不用为安全买单。
中国开源模型在溯源分析中展现出的安全能力,恰恰说明了一个关键道理:没有安全兜底的性能突破,越强越危险。
跑分可以刷,价格可以烧,但用户的数据安全、社会的公共安全,刷不了也烧不起。这场大战真正的胜负手,不在谁的模型跑得快,而在谁能让AI跑得稳。