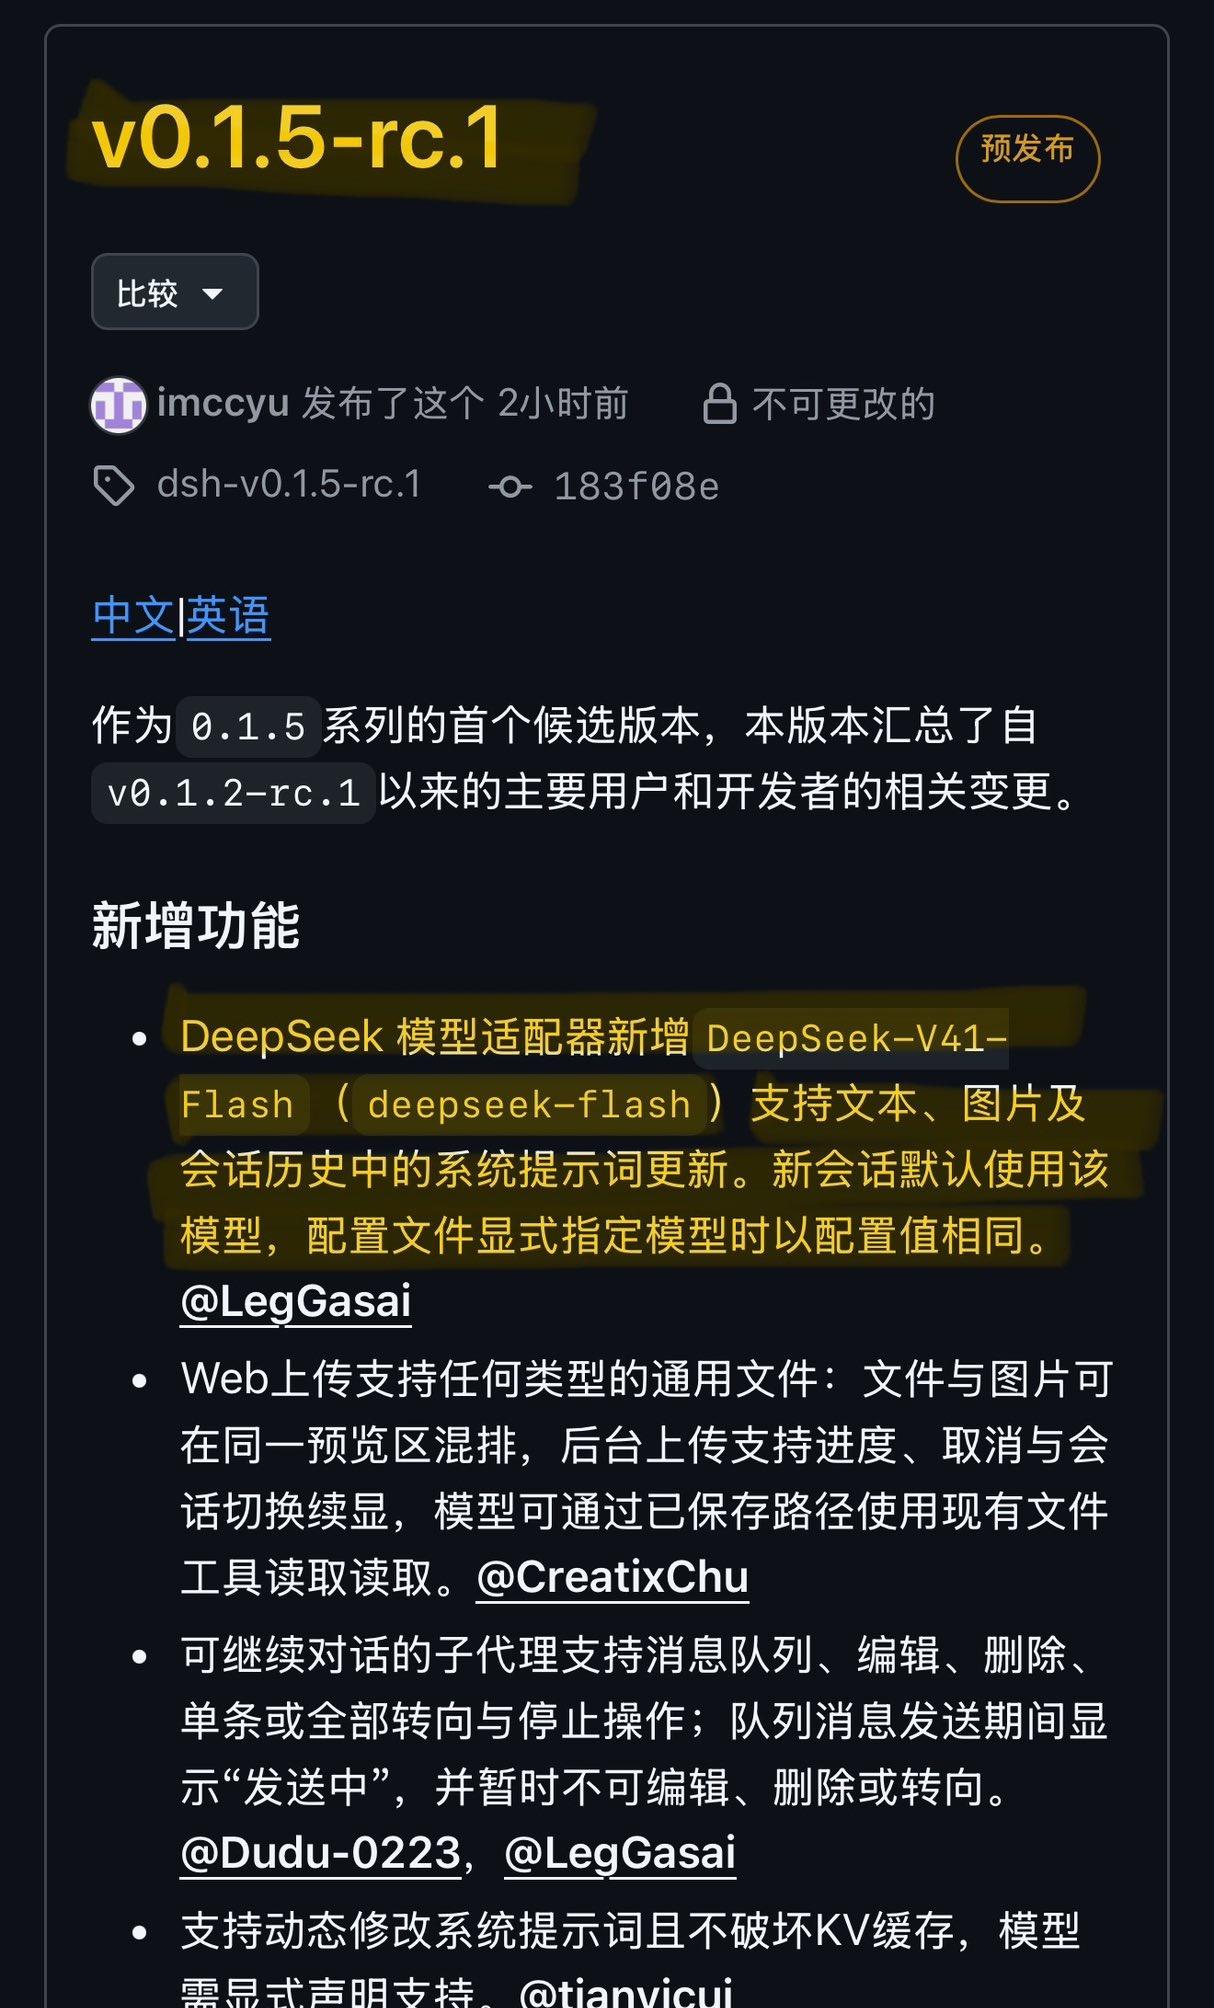
DeepSeek又掀桌子,新模型比自家旗舰还强
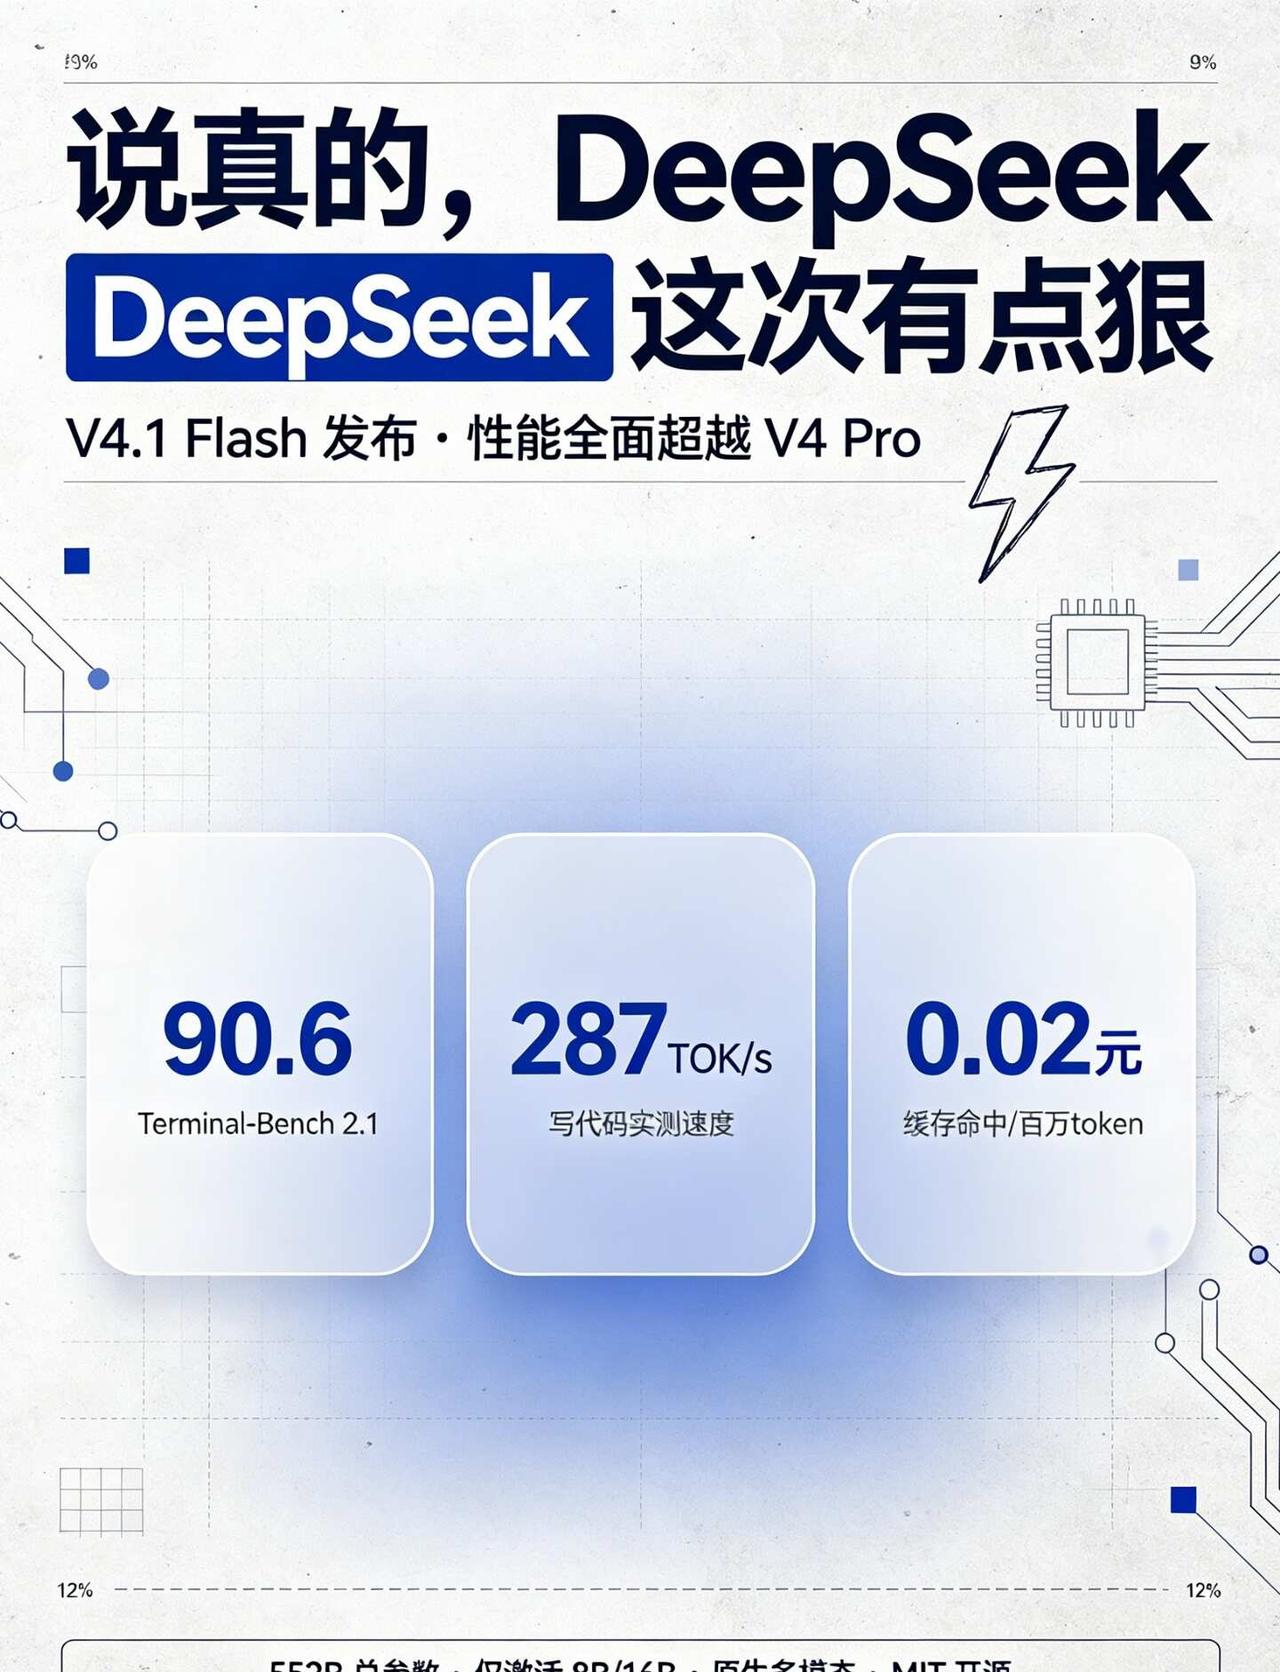
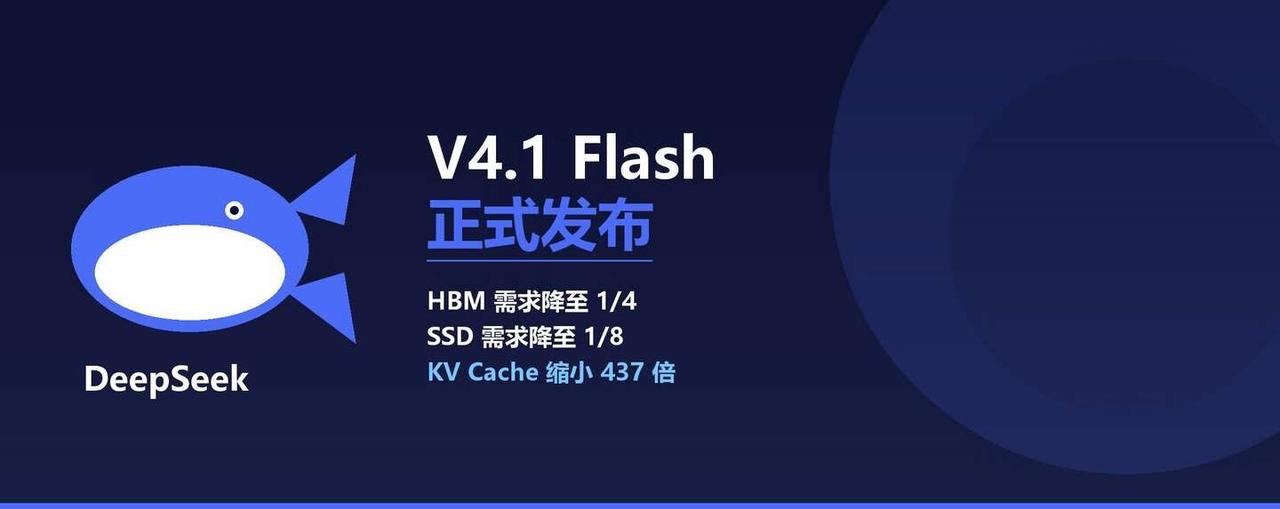
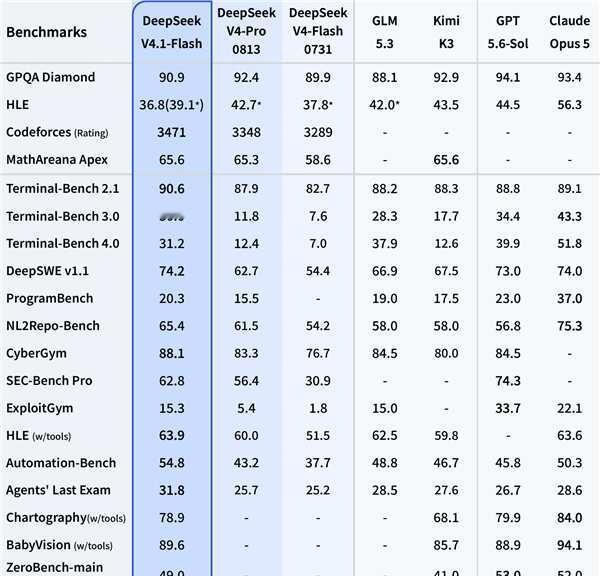
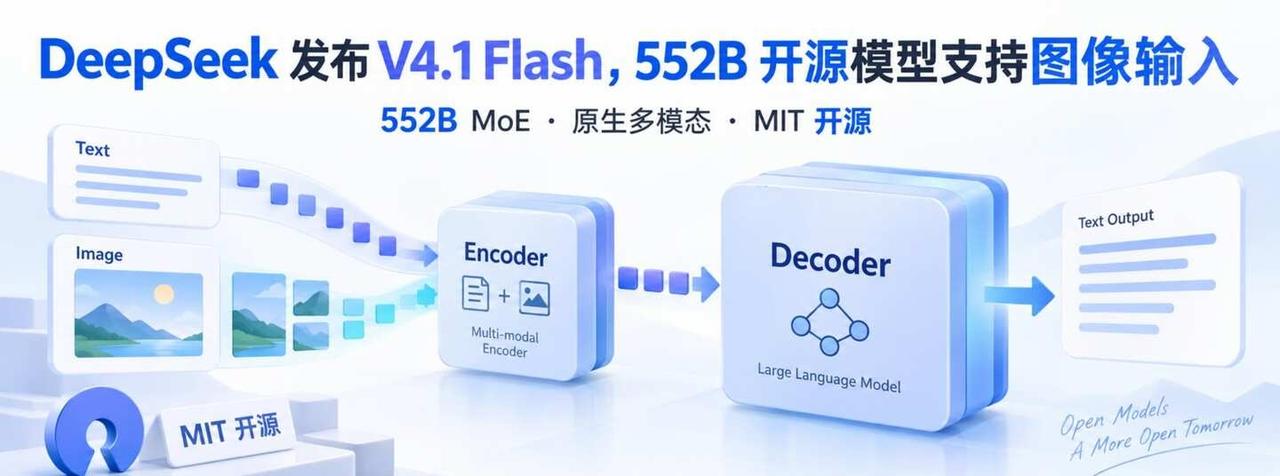
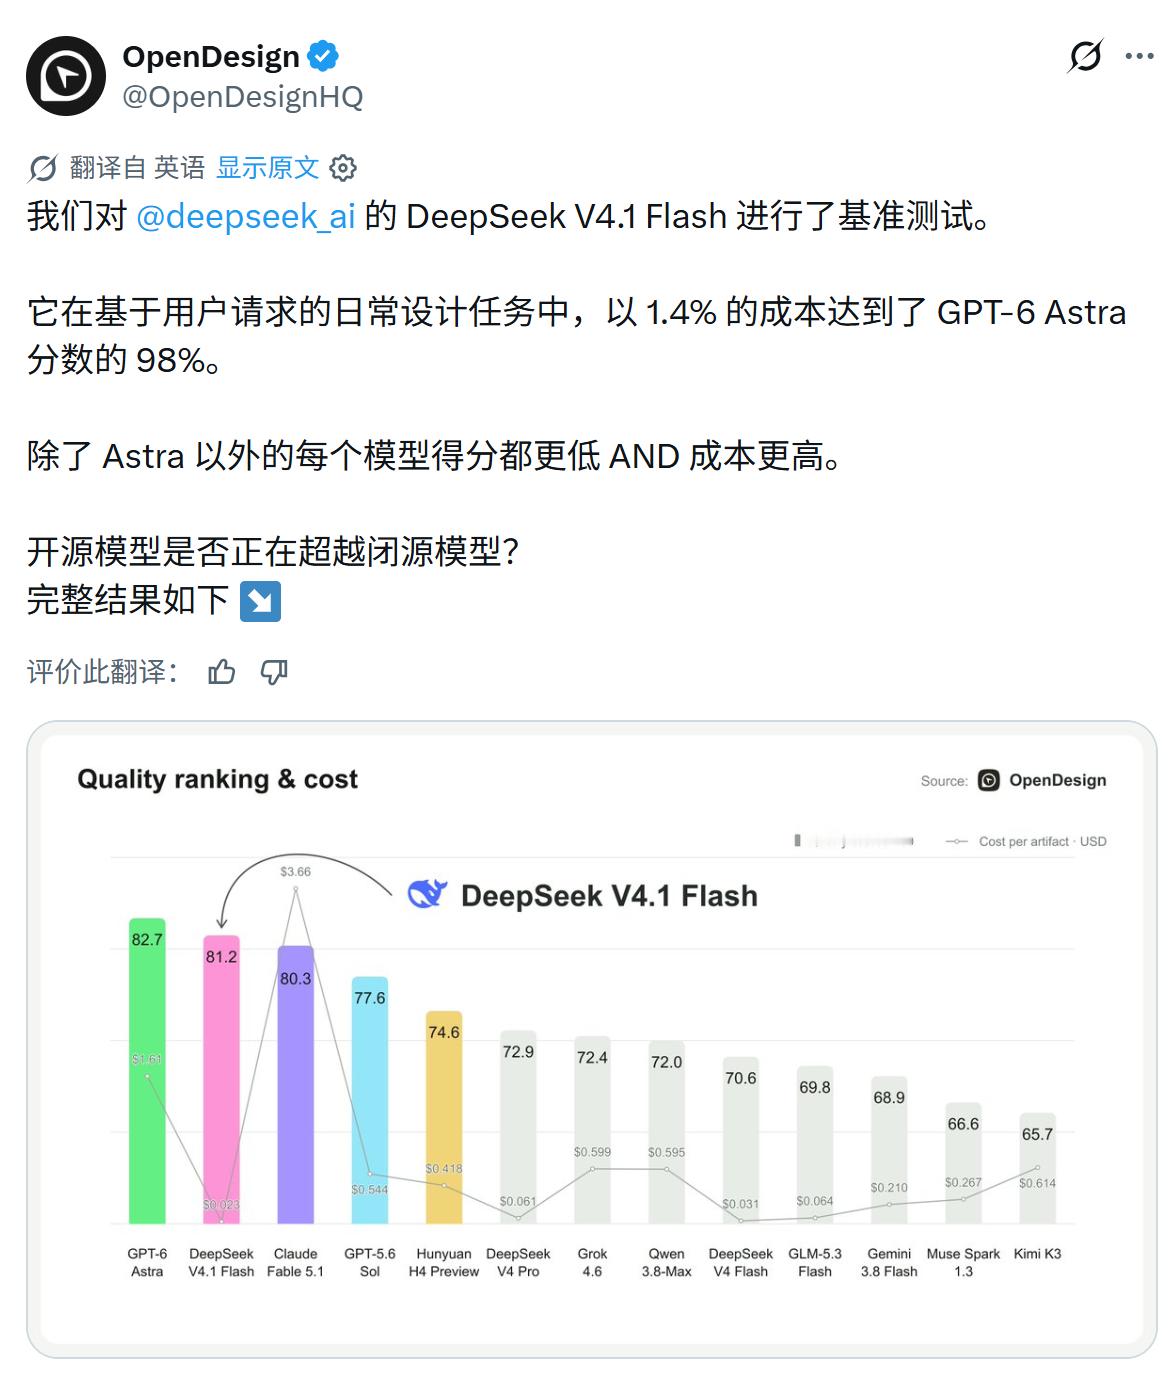
9 月 10 日发的 V4.1 Flash,是他们新架构里尺寸最小的一个。结果发布当天,各项测试把自家旗舰 V4 Pro 全超了 😳
它小在架构上
总参数 552B 听着唬人,输入却只激活 8B,输出 16B。用到哪块开哪块,所以又快又省
成绩单也够看
Terminal-Bench 2.1 拿 90.6,DeepSWE v1.1 是 74.2%,GPQA Diamond 90.9。这分数放半年前,是要开发布会讲的
不只是快
有博主拿同一句提示词让两个模型各写一万字小说,V4.1 Flash 跑到 160 TOK/s,V4 Pro 只有 50。写代码更夸张,287 TOK/s,屏幕上的代码基本是刷出来的。首 token 延迟也差三倍,体感就是秒回和等一下的区别
价格是真降了
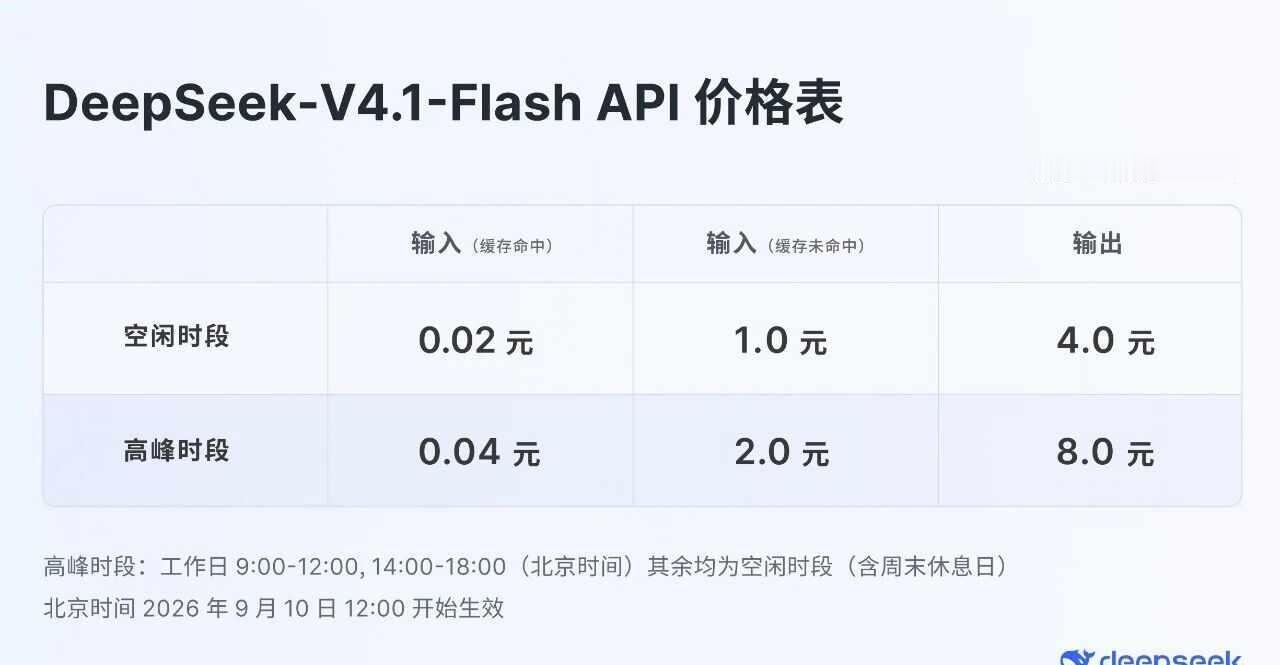
缓存命中的输入 0.02 元一个百万 token,没命中的 1 块,输出 4 块,高峰时段翻倍。跟上一代比,光缓存命中这项就降了 60%
有博主实测,V4 Pro 做个 3D 城市生成器花了 16 块左右,V4.1 Flash 做完两个项目不到 10 块 💰 具体账单还得看你自己用量,我这边只是照着公告念的
还有个细节
它原生支持多模态视觉理解,写完前端能自己截图看效果、自己改。以前那种写完不知道长啥样、还要叫个子 Agent 帮忙瞅一眼的割裂感,这次没了。
接下来这段有点争议
官方说 9 月 14 日 12 点之后,调用 deepseek-v4-pro 的请求会全部自动转到 V4.1 Flash 并按 Flash 计费,直到 V4.1 Pro 上线。本来是升级又降价的好事,评论区却吵翻了。开发者觉得不该替用户做决定,已经调好的提示词可能依赖旧模型的行为,直接换会影响业务。
这事还没定论,用 API 的建议先测一轮再上生产 ⚠️
当然不是没毛病。有测试说它偶尔想太多,反复验证、过度推理,做复杂任务反而更慢。简单活记得收着点。
参数顺手记一下。上下文 1M 输入、384K 输出;MIT 许可,权重上了 Hugging Face;推理强度 1 到 100 档可调。
比较适合这几类人。天天写代码、尤其跑 Agent 的;要处理长文档的;预算紧又不想凑合的。
你最近在用什么模型写代码?评论区聊聊 👇
DeepSeek 人工智能 大模型 程序员 国产大模型