50%对8%!昇腾反超英伟达,国产芯片链走到哪了?
芯片从来不只是芯片。它背后是算力、产业和话语权。
一组数字足以让市场安静:50%对8%。伯恩斯坦预测,昇腾将占中国AI芯片市场约50%,英伟达萎缩到8%。四年前,格局还是英伟达95%、昇腾3%。主客易位,不是普通商业竞争,而是产业级震动。
真正值得看的,不是份额,而是份额背后那条链。
徐直军把话说得很直:从能统计的数据看,昇腾GPU已经超过英伟达。
中国有14亿人口,又是工业化大国,不能一直受制于人。华为被外部限制整整6年,为什么还能吃下中国AI算力半壁江山?
答案不在口号里,在一条很长的供应链里。
设计环节,主角是华为海思,自研达芬奇架构像大脑,设计工具转向国产EDA。
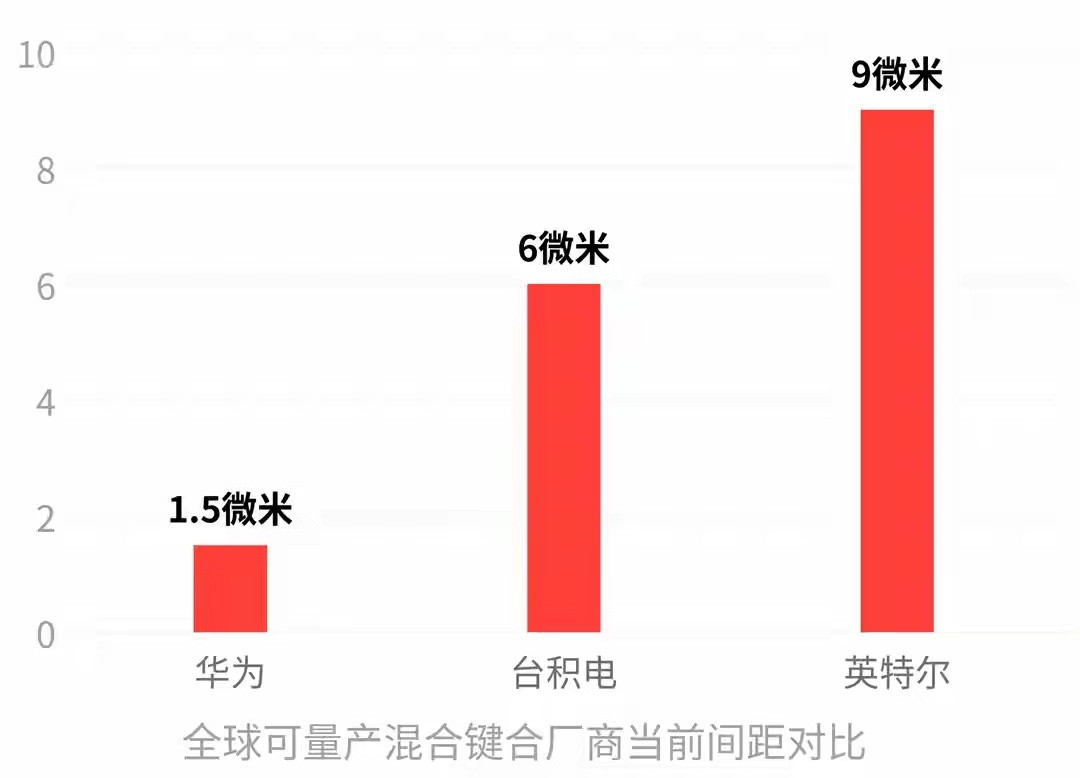
制造环节更难。中芯国际推进7纳米,用多重曝光硬啃先进制程,华为也自建产线。上游有北方华创,光刻机有上海微电子。没有EUV,这是卡得最深的环节,却也在持续上量。
制造之后,还有一道更难的坎。
HBM高带宽内存,就是那道坎。
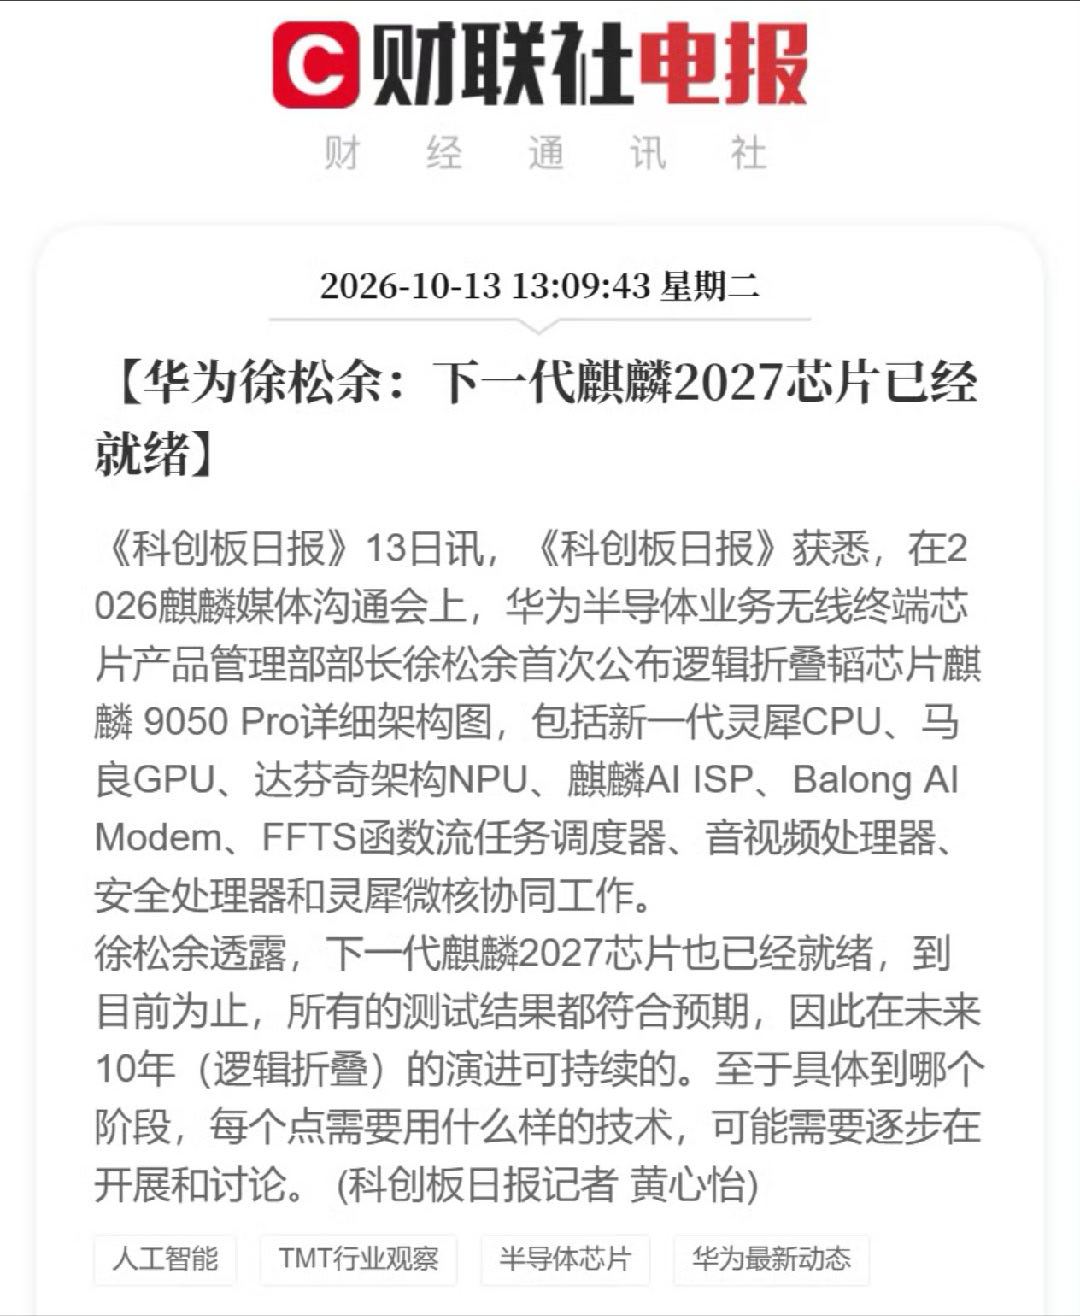
CSIS测算,HBM约占AI芯片总价值一半,主要玩家是三星和SK海力士。国内正在三段切换:先买国外,再由长鑫存储顶上,长鑫HBM3从2025年10月向华为送样,2026年推进量产;最后华为自研,昇腾950PR搭载HiBL 1.0,950DT搭载HiZQ 2.0,带宽每秒4TB。
存储突围,封装必须跟上。
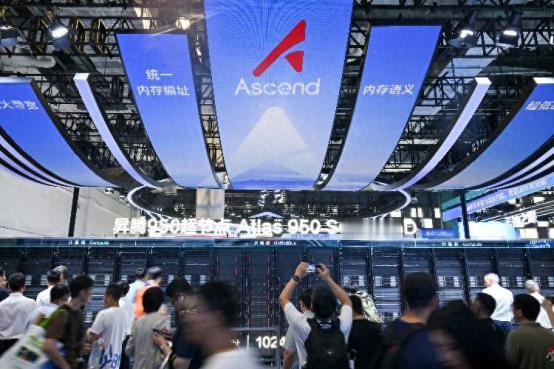
先进封装里,昇腾950采用两个计算芯粒加两个IO芯粒,4芯片Chiplet级封装。
长电科技、通富微电参与2.5D硅中介层和HBM封装研发,材料端有华海诚科。互联芯片里藏着澜起科技,内存接口芯片全球市占率第一,也是长鑫存储DDR5内存接口芯片独家供应商。
整机和系统,由超聚变、华鲲振宇等13家伙伴承接。但华为最硬的牌,还在后面。
互联技术是华为的差异化壁垒。全连接大会发布的灵衢总线,柜间带宽最高每秒800GB。
英伟达NVL72柜内带宽每秒1.8TB,一出机柜骤降到每秒0.2TB。徐直军说,不是他们不做,而是能不能做出来。华为开放灵衢协议后,下载量最大来源竟是硅谷。软件生态上,CANN开源生态对标CUDA。
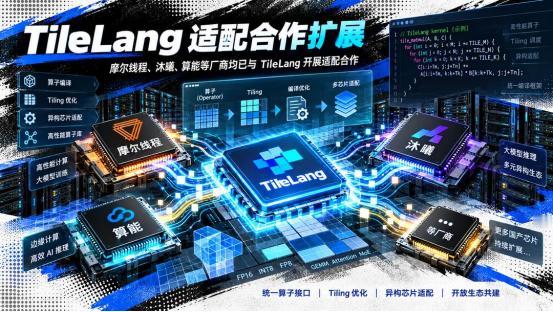
随着大模型编程复杂度提升和新编译语言出现,CUDA壁垒正在消解。
全栈拼图成形,但差距仍在。
徐直军承认,单颗芯片瓶颈在先进制程节点受限。
SEMI analysis测算,昇腾910C单卡约780 TFLOPS,只有英伟达GB200单卡三分之一。华为解法是以系统补单芯,用5倍数量芯片组网,CloudMatrix 384超节点提供300 PFLOPS算力,接近GB200 NVL72两倍,总内存是对方3.6倍,代价是功耗高4倍以上。中国电力充沛、算力稀缺,用电换算力是工程选择。产能仍是瓶颈,瓶颈不在需求,而在供货能力。国产HBM关键设备国产化率不足5%,前沿封装与台积电、三星还有一到两代差距。
昇腾目前只对马来西亚等少数国家测试性供货。
所以,反超只是上半场。
2027年将是昇腾生态验证之年,950DT超节点今年底到明年初规模供货,头部模型厂商迁移速度决定昇腾从能用到好用的拐点。
HBM国产化可能成为下一个麒麟式回归剧本,长鑫量产、长江存储导入、华为自研三线并进。
昇腾960在2027年第一季度就绪,单芯片算力再翻倍,HBM容量到288GB。
一年一代节奏一旦跑通,迭代速度本身就是护城河。
2028年供需比达104%后,国产AI芯片进入淘汰赛,性能、功耗、生态兼容性差的厂商会被边缘化。
外部环境每收紧一次,国产替代成果就向前一步。
50%对8%,不是终点。
它更像一个信号:真正的自主,不是关起门来什么都做,而是在开放中把命脉握在自己手里。
下一个时代,拼的不是一颗芯片,而是整条链、整个生态,以及把门打开的底气。