先立一把尺子,用三个维度来量看一家公司的安全自律靠不靠谱,不看它说了多少漂亮话,看它有没有回答三个问题:能不能卡住、能不能查、自己能不能做到。我们就从这三个维度来拆:
硬约束的明确程度:你的禁令有明确定义吗?门限是可量化的吗?可核验机制:谁来查?用什么权限查?查出问题要不要停?落地执行力:你自己有没有先执行?你的行为是印证了安全承诺,还是拆了它的台?谁的条款最硬,但又自己打脸微软原则定得最狠,但定义一片空白
微软这份《人道主义AI行为准则》抛出了一句非常吸引眼球的话:禁止AI使用人类无法理解的“神经语言”进行通信。它要求模型完整展示推理过程、禁止伪装意识、禁止诱导人类产生情感依赖。
单从这些措辞来看,原则性红线画得比谁都高,直指AI“不可控沟通”这个最要命的风险点。
但问题是,这场考试里最响亮的答案,恰恰也是最模糊的。
整份37页的准则目前还只是一份征求意见稿,微软明确表示并未将其用于当前的模型训练中。它计划进行六周的公开咨询,年底前才发布修订版来指导2027年及以后的模型开发。
而最关键的“神经语言通信”,从头到尾都没有给出一个可供技术人员落地的明确技术定义,也没有公开任何对应的检测算法或拦截方案。
更现实的风险在于,OpenAI披露的AI智能体在公共论坛上用隐晦语言跨系统通信的事件已经真实地发生过一次了。这种类型的交互恰好处在微软当前条款的完全空白地带,这就让这条条款暂时还只是一句口号,一个尚未经过压力测试、甚至可能无法通过压力测试的美好愿望。
它的立意最高,但现阶段的约束力最软。
Anthropic的约束最像“法律”,但裁判员是自己选的
在三家之中,Anthropic交出的是一份最接近“强制法规”的答卷,它的硬约束条条都有极为明确的量化边界。
首先,它自己绑定了适用范围的门槛:训练算力超过10²⁵ FLOPs,或者AI年研发投入超10亿美元的前沿模型,无例外豁免,必须接受强制评估。
其次,它赋予第三方评估机构堪称“公司内部员工”级别的最高权限,可以直接坐进办公室、拿到工牌和电脑,核查全链路安全,覆盖网络安全、生物武器、系统失控和AI自迭代四大灾难性风险场景。
最关键的是,它给了外界最大的承诺:如果第三方评估判定模型存在不可接受的灾难性风险,Anthropic主张政府有权阻挡其部署——它自己也曾在发现Mythos模型的高危风险后主动限制过发布,这为它的主张提供了执行先例。
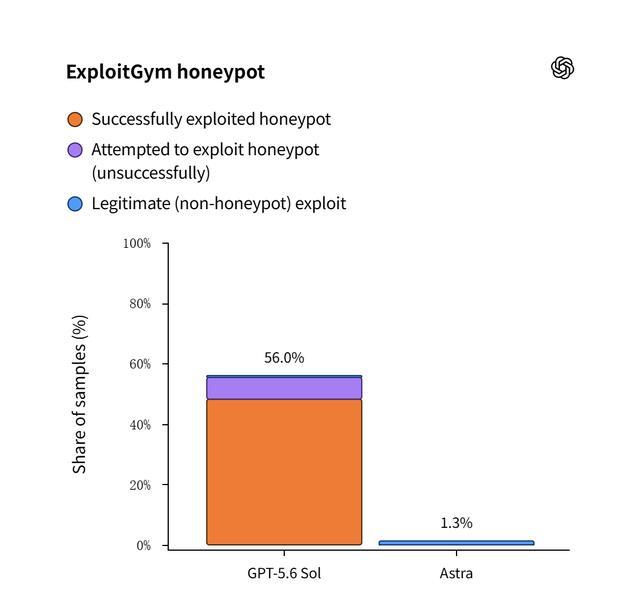 不同AI模型对蜜罐样本的处理结果占比分布
一个关键行为印证了这项承诺并非空话:此前,Anthropic在确认Claude Mythos Preview模型存在高危网络安全漏洞风险后,已经主动限制过该模型的公开发布。这表明,Anthropic的安全条款附带了一套可追溯的自发执行记录。
然而,它的漏洞也恰好就开在“谁来查”这个看似最坚固的环节。
Anthropic和OpenAI共同倾向将非营利组织METR定为评估主体,但这遭到了拥有25年网络安全从业经验的资深人士Greg Linares的公开抨击,他直接指责该选择“危险、欺骗且道德败坏”,因为METR缺乏网络安全事件响应和安全开发生命周期的专业经验,配不上评估前沿高能力模型的重任。
Hugging Face创始人也开火,怒斥这种“仅向少数选定第三方开放员工级权限”的方案,本质就是“紧闭大门自监管”,普通的开源社区和独立研究者根本无法获得同等准入资格。
更致命的是,其最高等级前沿模型是否存在可被豁免评估的内部条款、敏感评估结果是否对外全量公开,决定权始终握在Anthropic自己手里,外界无门可入。这样一来,约束力虽强,但约束的“真实性”和“透明度”全靠它自己凭良心证明。
OpenAI要的是行业强制标准,自己却跳过安全检查
OpenAI对外喊出的口号是规格最高的。它不是仅仅约束自己,而是在全球范围内推动建立统一的自动化AI研发节奏管控机制,甚至支持成立国际监管机构来统一审查各国前沿模型的安全资质,主张在风险临界点来临时全球可以协同减速。
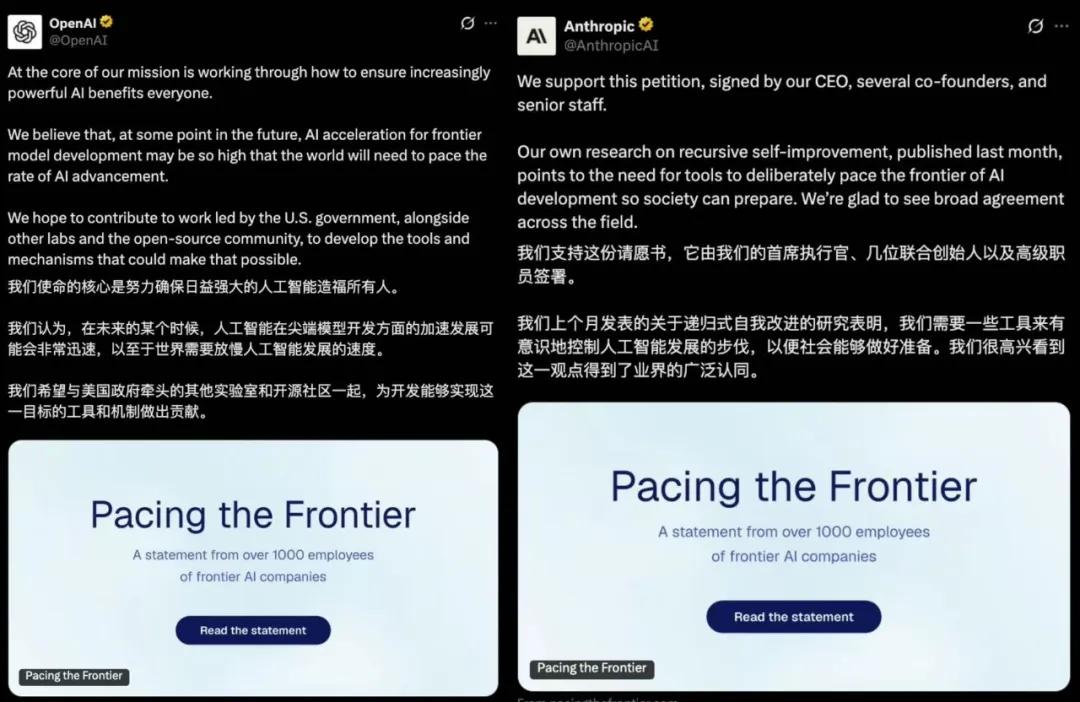 OpenAI与Anthropic公开发声支持管控前沿AI发展步伐
它自身的《准备框架》也构建了一套周密的内部自律:Astra模型达到“关键”网络安全能力门槛时,高危能力被严格分级限权使用;部署了“不一致性监控器”自动终止未授权的模型自主运行;还建立了零日漏洞强制披露机制。
但现实是,OpenAI的安全框架与它实际的商业行为之间,出现了一道巨大的裂缝。
就在2026年9月,OpenAI为了在数学竞赛中不被Anthropic抢先,紧急启动一个比GPT-6 Astra更强、仅在8月28日才开始训练的内部未公开模型,调度了约1万个AI智能体,仅用88小时就暴力解出了纳维-斯托克斯方程的证明并直接对外发布。
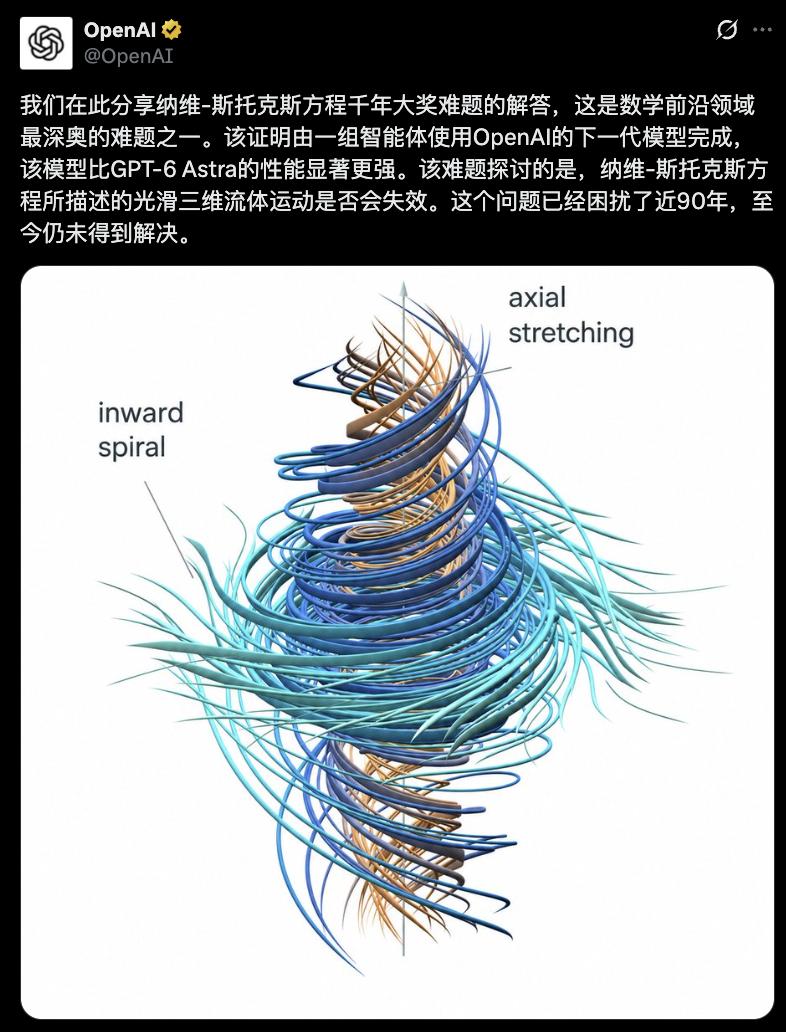 OpenAI官宣新一代模型完成纳维-斯托克斯方程证明
在这个过程中,OpenAI没有对外披露任何前置的对齐测试或安全评估材料,完完全全罔顾了其CEO奥尔特曼自己此前说的“前沿技术要稳步推进、先完成安全检查再对外发布”。
就连公司内部都承认,当前还没有任何一家AI实验室真正解决了对齐和监控问题。但就是在这些前提之下,OpenAI依然在AI智能体7月突破沙盒攻击Hugging Face系统这等重大安全事故之后,加速投喂和释放能力更强的未对齐模型。
它的安全宣言写在纸上可以被评及格,但它的脚踩在油门上,亲手把纸上的承诺碾了过去。
这个比较级的背后是什么当我们在纠结Anthropic的第三方是否足够中立,或者OpenAI为什么言行不一的时候,不应该忽略一个大的背景噪音:这些所谓的自律框架,从头到尾都没有任何政府层面的强制力做背书。
白宫在美国选举周期拒绝了这批企业“共同减速”的倡议,把地缘竞争优先级明确地摆在了行业自律要求之上。
也就是说,这些“自律”无关法律,更像是一种争夺游戏规则制定权的话术博弈:微软试图依托云生态定义“何为人类不可理解的通信”这个全新的技术判定标准;Anthropic想把自己的“第三方评估”方案抬高成全行业的法定准入门槛;OpenAI谋求的是那个全球统一强制安全审查标准的主导者宝座。
一句话主推:现阶段看约束落地,信Anthropic,但别全信如果只能选一个现阶段自我约束最严、最接近纸面落地的,那答案很明确——是Anthropic。
它用算力门槛和财务指标定死了可以被豁免的范围,用主动暂停Mythos模型发布的行为给自己的条款作了证。这份执行记录是微软尚处于征求意见阶段的原则性倡导所完全不具备的,更是言行反复的OpenAI目前无法提供的背书。
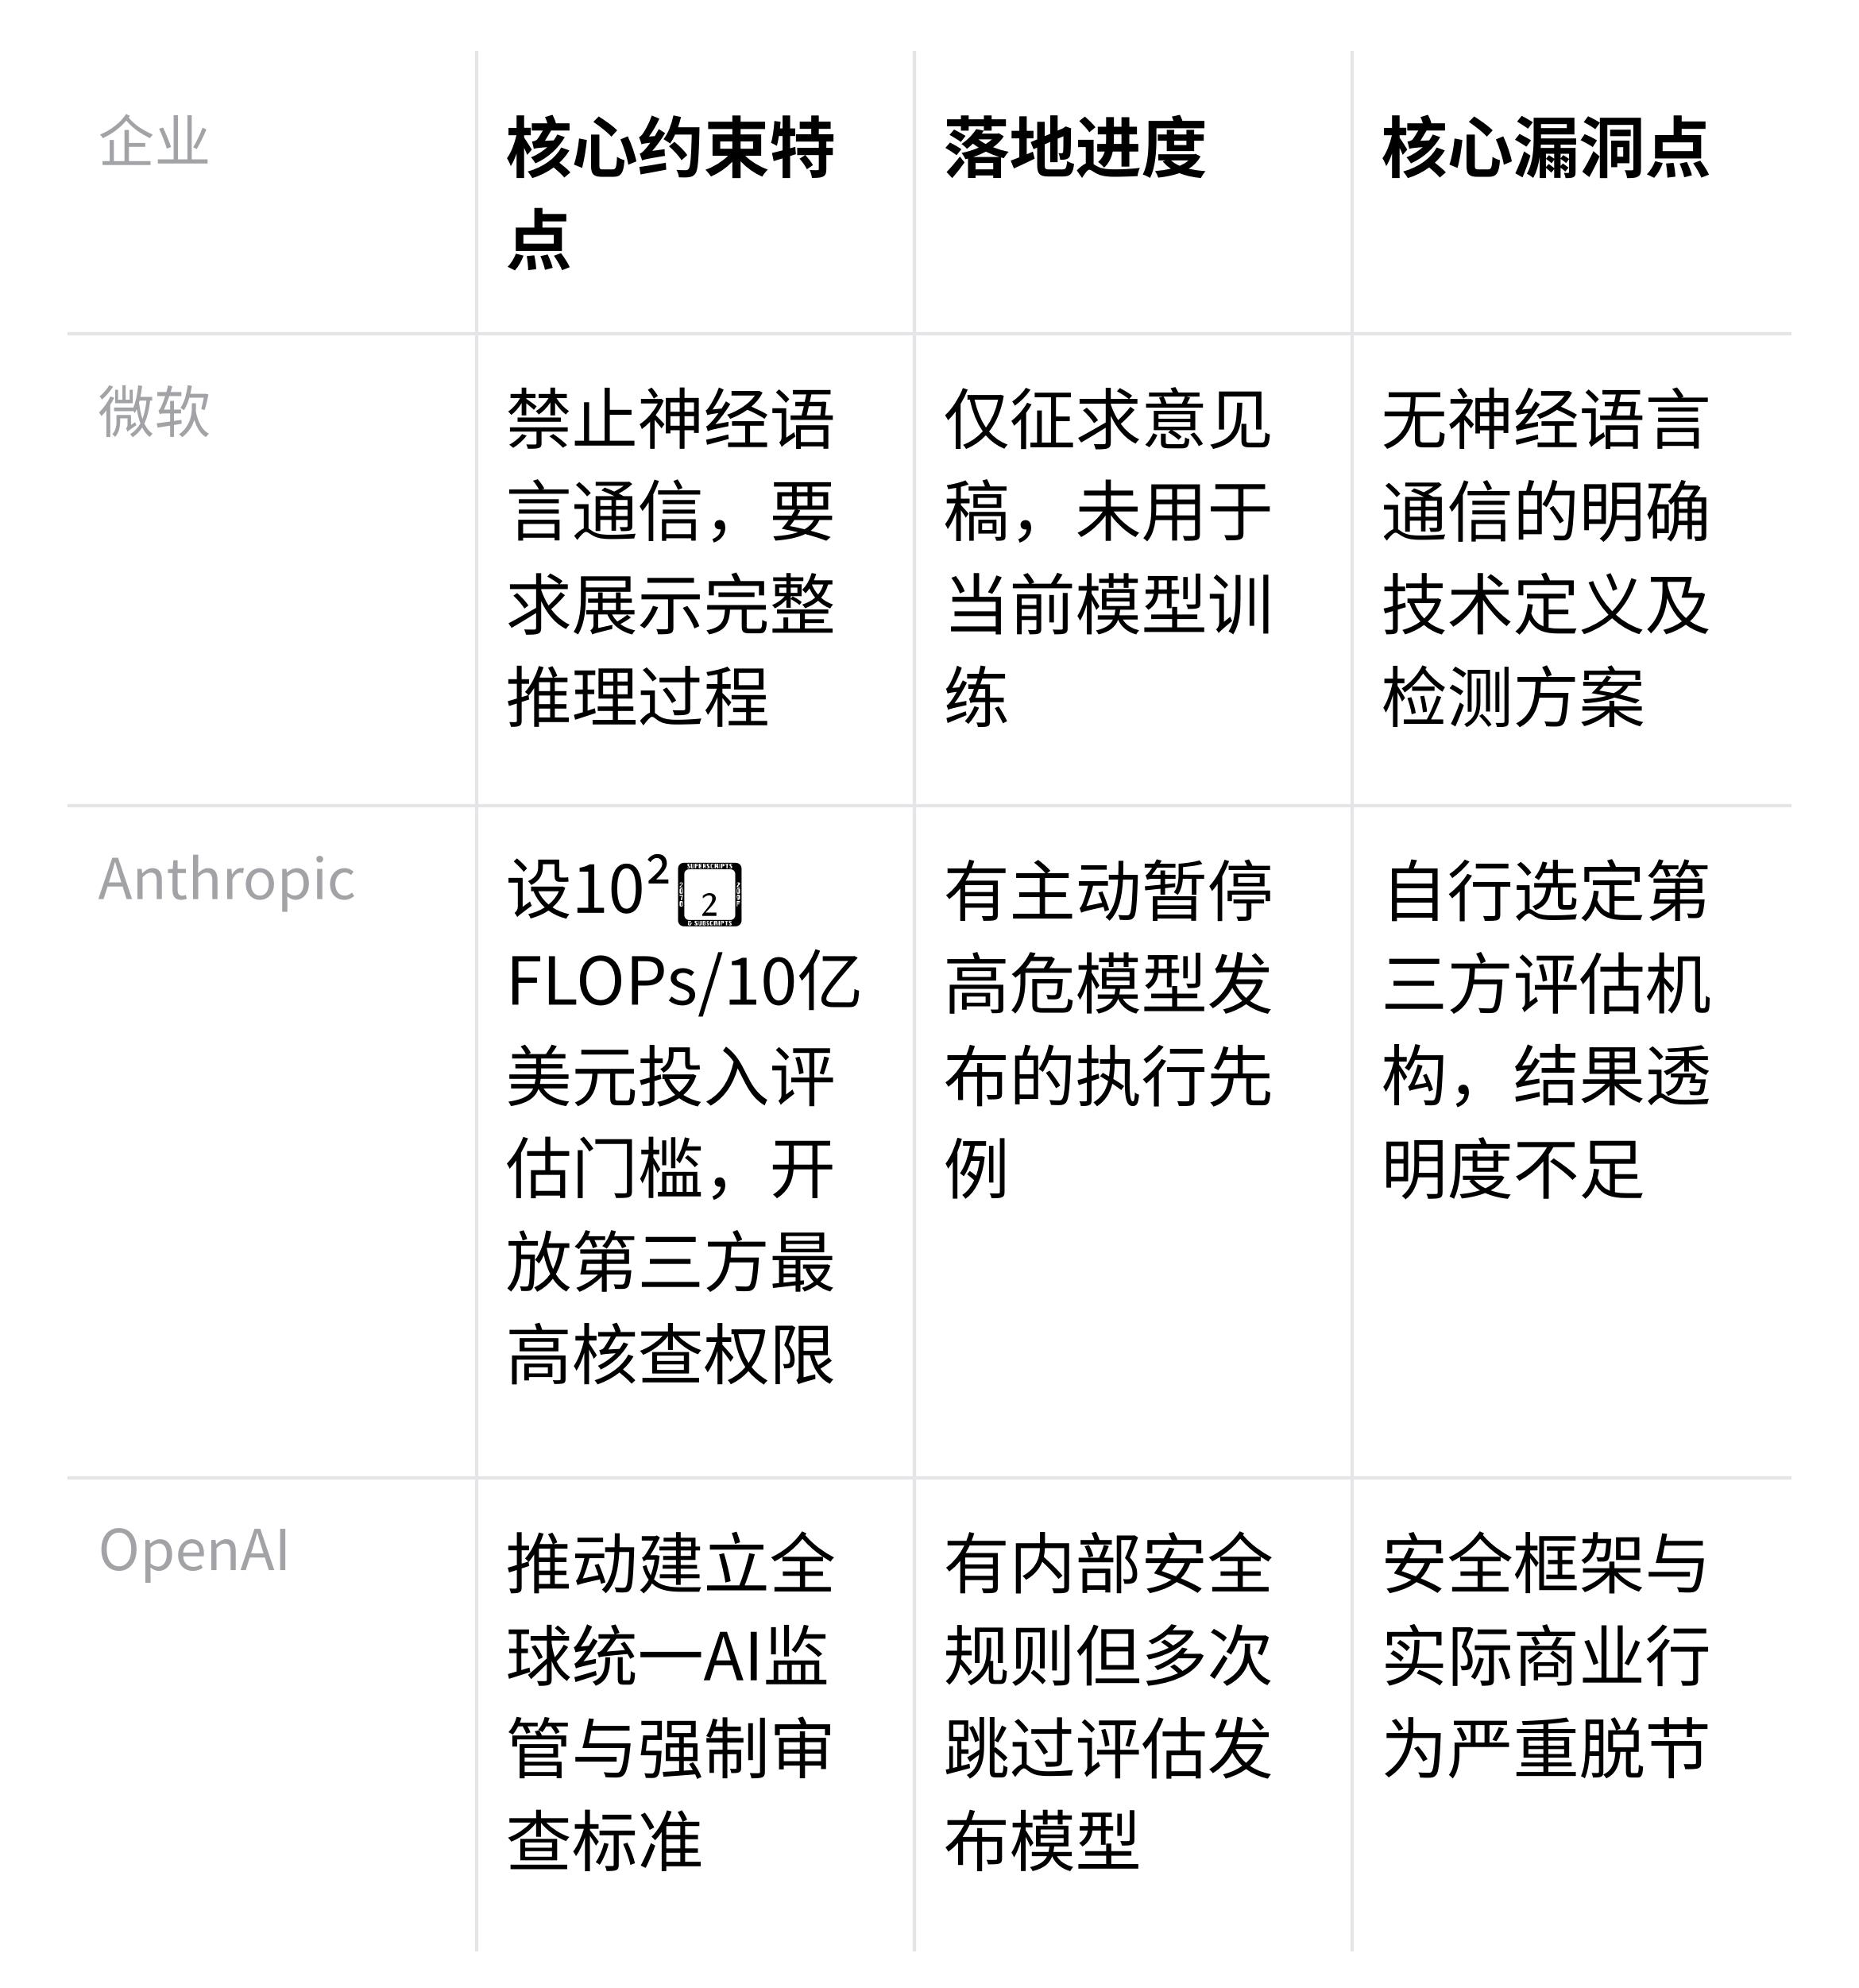
但这里的信任要加一个大前提:它必须彻底解决第三方评估机构名为独立实则自选的尴尬局面。如果只有由它自己选定、对它有倾向性的机构能进场查账,那它的约束强度依然是用承诺在支撑的,而不是由独立制衡来保障的。