9 月 22 日,Anthropic 把 Claude Opus 5.5 摆上货架,旗舰价格压到输入 4 美元,输出 20 美元。不到 90 分钟,OpenAI 推出 GPT-6 Sol 与 GPT-6 Luna,定价单写着输入 2 美元,输出 10 美元,Luna 更是低到输入 0.1 美元。
这不是一次常规降价,而是贴着对方报价单打出去的一记回敬。两家同一天出牌,中间只隔约一个半小时,OpenAI 挑的落点恰好压在 Opus 5.5 的价位带上。
先把结论放在前面,这一轮突袭打的是价格,不是能力。
90 分钟,两家的报价单叠在一起
Anthropic 在美东 9 月 22 日(周二)发布 Claude Opus 5.5,价格改为每百万 token 输入 4 美元,输出 20 美元,相比 Opus 5 各降 20%。
随后大约 90 分钟,OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna。
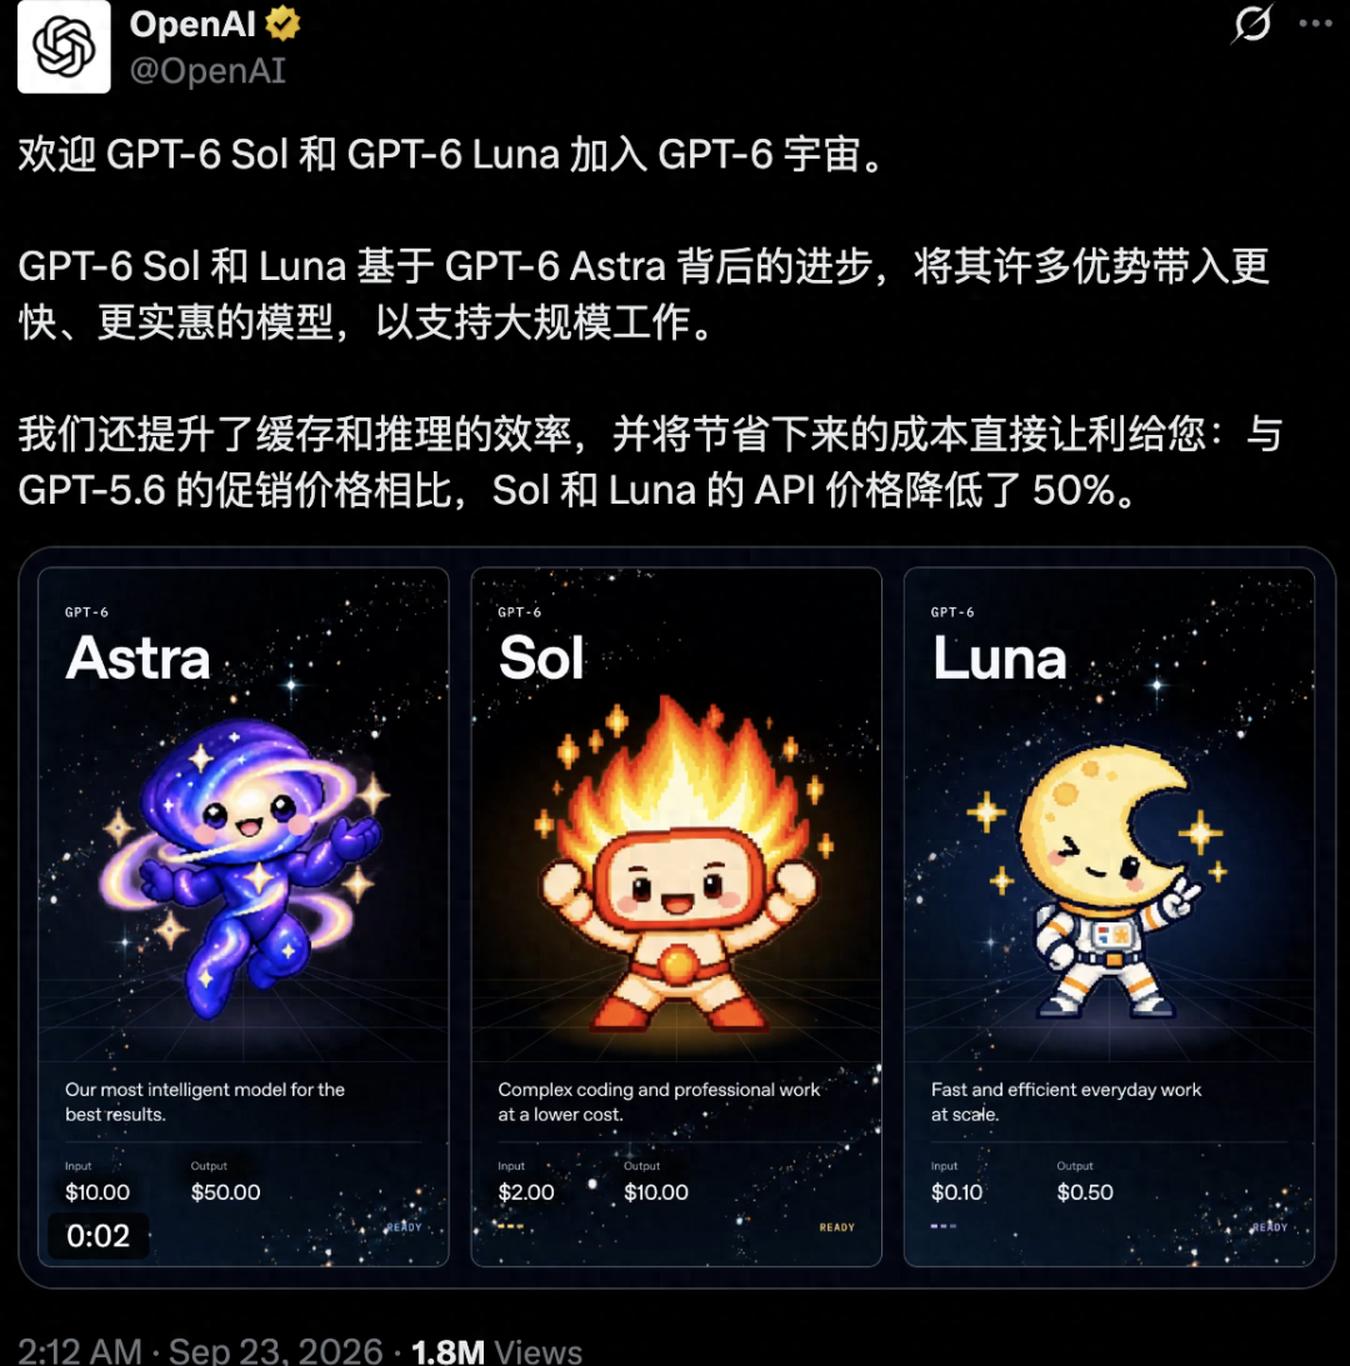 帖子写明两款模型加入 GPT-6 宇宙,缓存与推理效率提升带来的节省直接让利,API 价格较 GPT-5.6 促销价降低 50%
GPT-6 Sol 定价输入 2 美元,输出 10 美元,前代 GPT-5.6 Sol 是 4 美元与 20 美元。GPT-6 Luna 更狠,输入 0.1 美元,输出 0.5 美元,前代是 0.2 美元与 1.2 美元。
GPT-6 Sol 输入$4 → $2
GPT-6 Sol 输出$20 → $10
GPT-6 Luna 输入$0.20 → $0.10
GPT-6 Luna 输出$1.20 → $0.50
单位,每百万 token。数据出自 OpenAI 官方公告与 API 文档。
有一处最容易被写错,必须先说清。OpenAI 公告原话是「compared with GPT-5.6 promotional pricing」,拿 GPT-5.6 的促销价做基准。Luna 输出价从 1.2 美元降到 0.5 美元,实际降幅 58.3%,并非 50%。只有 Sol 是输入输出两边都精确降半。
 OpenAI 官方公告原文。原文写明 50% lower API prices,比较基准是 GPT-5.6 的促销价
OpenAI 发言人向 VentureBeat 确认,这是永久定价,不是促销价,也不是引流入门价。所谓促销结束并没有发生,真正发生的是,促销变成了常态价。
Astra 的底子,砍掉一半的钱
Sol 与 Luna 不是新架构,是把 GPT-6 Astra 的能力往下放。OpenAI 在公告里写,两个模型用了与 Astra 相似的训练方法,把 Astra 在专业工作,事实性,编程,计算机操作与对齐上的进展,搬到了更快,更便宜的模型上。
上下文窗口1,050,000 token
最大输出128,000 token
推理档位none / low / medium / high / xhigh / max
知识截止 Sol2026 年 4 月 20 日
知识截止 Luna2026 年 5 月 18 日
API 调用名gpt-6-sol / gpt-6-luna
数据出自 OpenAI API 文档。两个模型的知识截止日期并不相同。
输入超过 272,000 token 之后,整条请求按长上下文价格计费,输入与缓存翻倍,输出按 1.5 倍算。注意是整条请求重新计价,不是只对超出的部分加价。
免费用户方面,Free 与 Go 只能在桌面端 ChatGPT 里用到 Luna,Sol 仍需 Plus 及以上。Codex 里的会话会被自动切到新模型,依赖 GPT-5.6 行为做产出的团队需要手动固定型号。
 OpenAI 官方公告的可用性说明。ChatGPT Work 与 Codex 面向付费档推出,Free 与 Go 只能通过桌面端用 Luna。
跑分表里的那个 11.1 倍
OpenAI 这次把成本优势直接做成了一张对比表,数字摆在台面上。发布当天 Sam Altman 也发了帖强调这一点,但真正硬的证据还得看下面的基准数据。
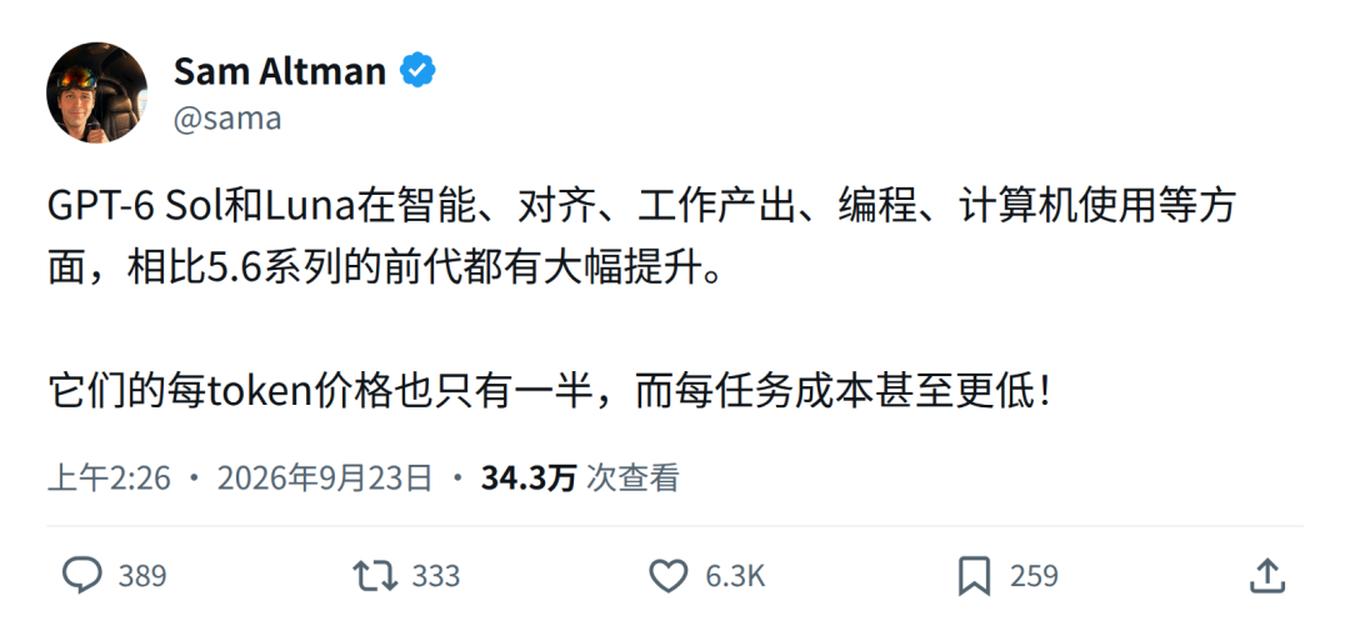 帖子写明两款模型在智能,对齐,工作产出,编程,计算机使用等方面比 5.6 前代都有大幅提升, 价格只有一半
落到 AutomationBench 这个基准上,GPT-6 Sol 在 xhigh 档得 33.2%,单任务花 0.27 美元。同一张表里,Claude Opus 5 在 max 档得 26.9%,单任务成本是 Sol 的 11.1 倍。连 OpenAI 自家的 Astra 也被拉进对比,low 档得 30.3%,成本是 Sol 的 3.9 倍。
GPT-6 Sol(xhigh)33.2% / $0.27
GPT-6 Astra(low)30.3% / 3.9 倍
Claude Opus 5(max)26.9% / 11.1 倍
Claude Fable 5.1(max)31.4% / 超 8.9 倍
Fable 5.1 这个数据点低估了它的真实成本,因为它没有计算 Opus 5 回退所产生的开销,而回退发生在大约 40% 的任务上。
OpenAI 官方公告图注,中文译文
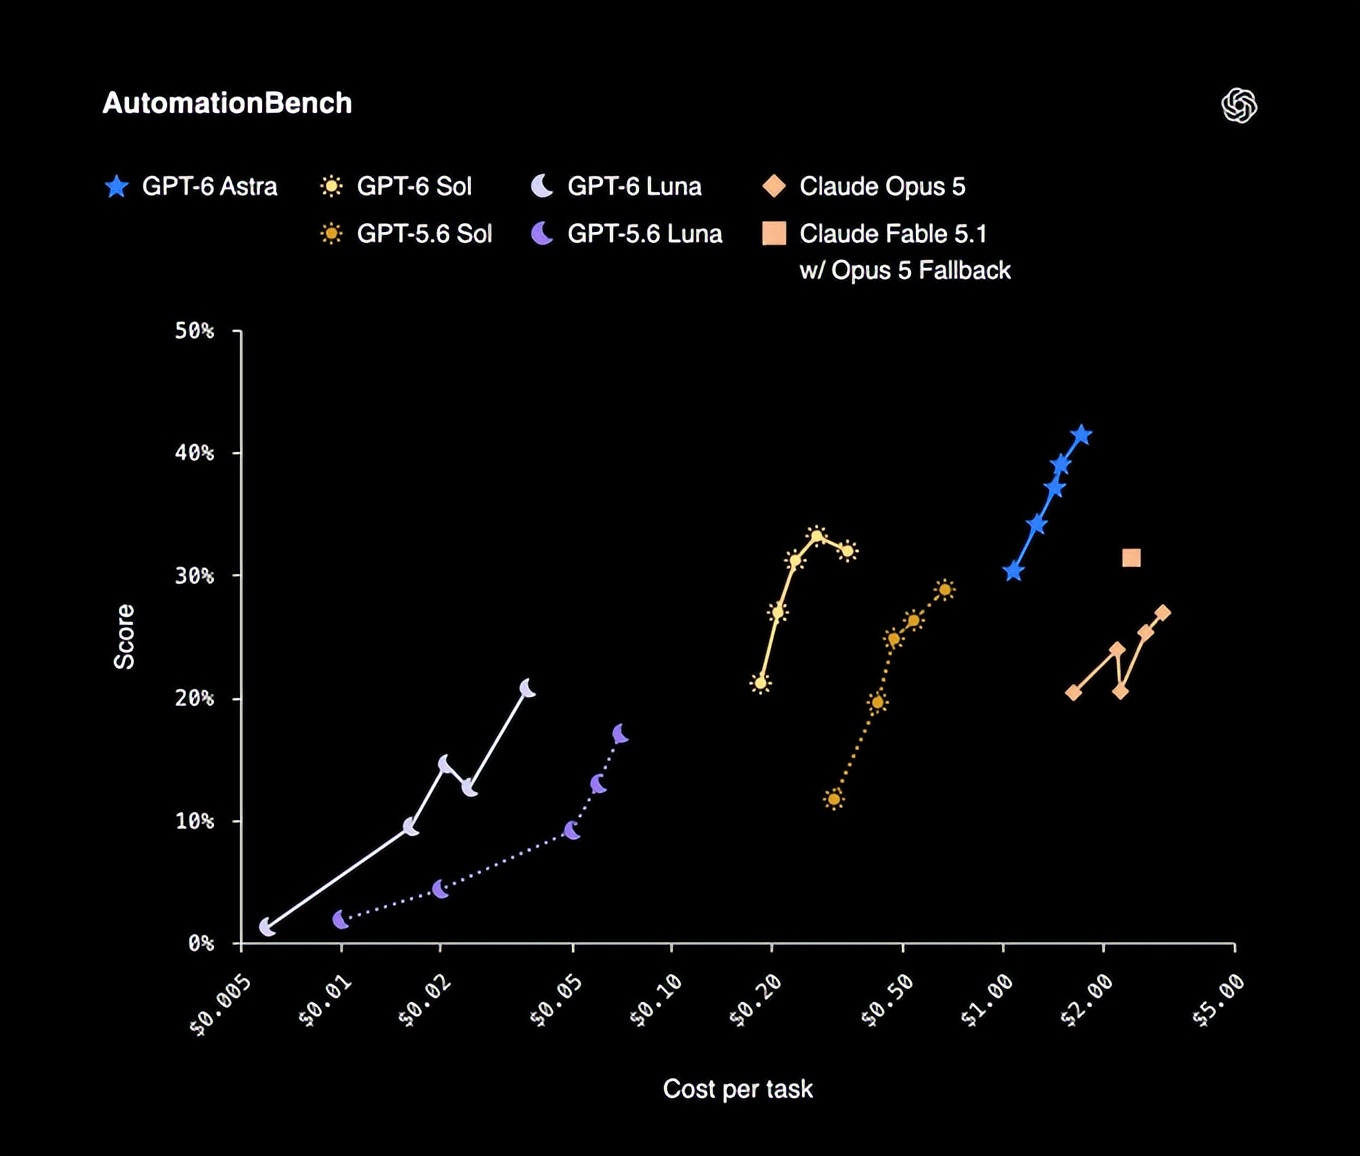 横轴是每个任务的成本,纵轴是分数,越靠左上越划算。GPT-6 Sol 的曲线在低得多的成本一侧
那个 11.1 倍是怎么来的。Sol 的每 token 单价大约是 Opus 5 的一半,但同一个任务 Opus 5 要吐出的 token 量又是 Sol 的好几倍,两个因子相乘,才是公告里这个数。
DeepSWE v1.1 上,Sol 在 max 档得 68.8%,与 Claude Fable 5 的最高分 69.9% 只差 1.1 个百分点,单任务成本低约 80%。
Agents Last Exam 上,Sol 在 max 档得 56.4%,高于 Claude Opus 5 在该评测的最高分,单任务成本低 60%。
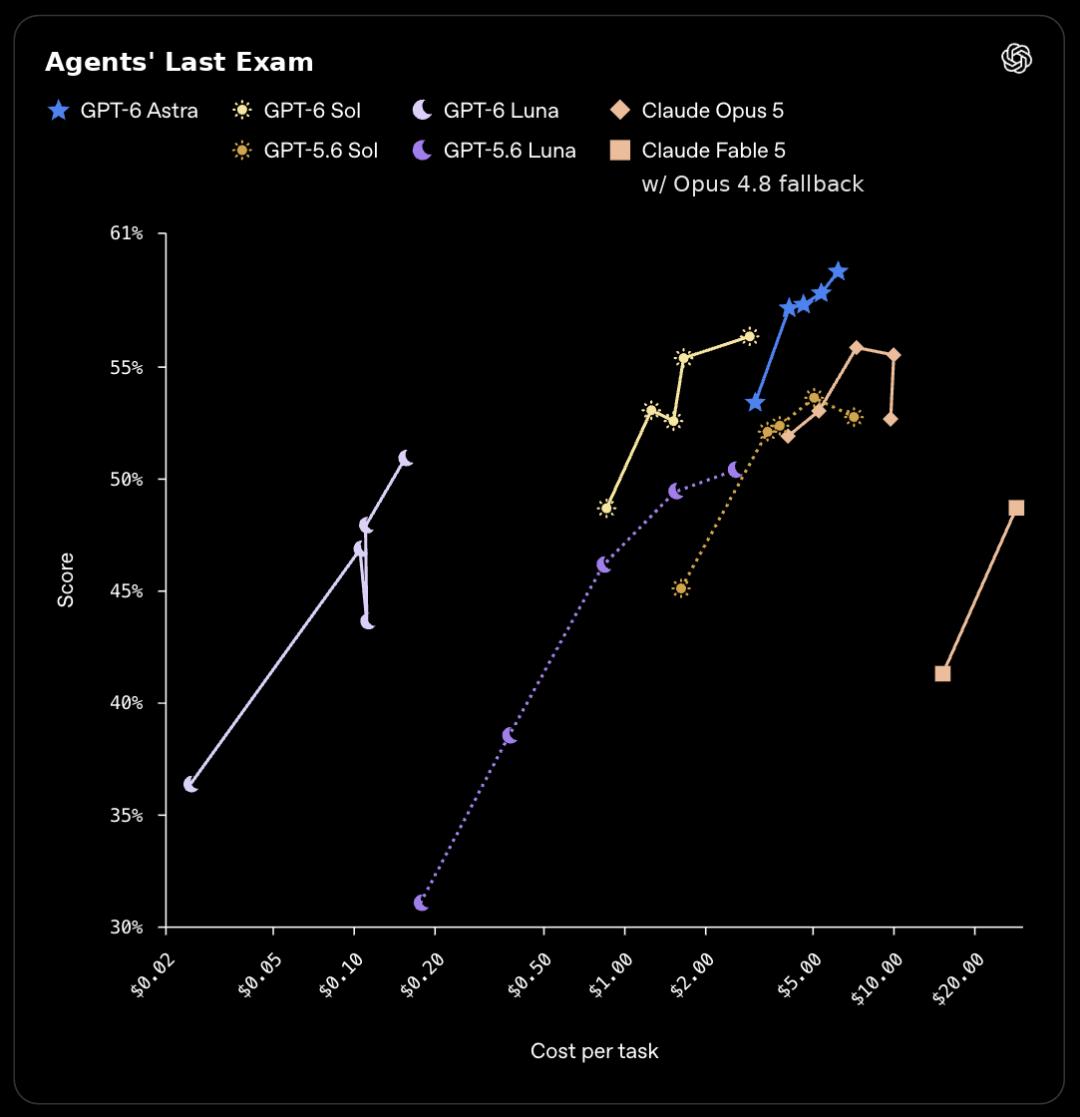 OpenAI 官方公告配图。Agents' Last Exam 横轴为单任务成本,纵轴为得分,越靠左上越划算
官方还放了一张更细的事实错误率图,看困难提示下模型答错的比例。
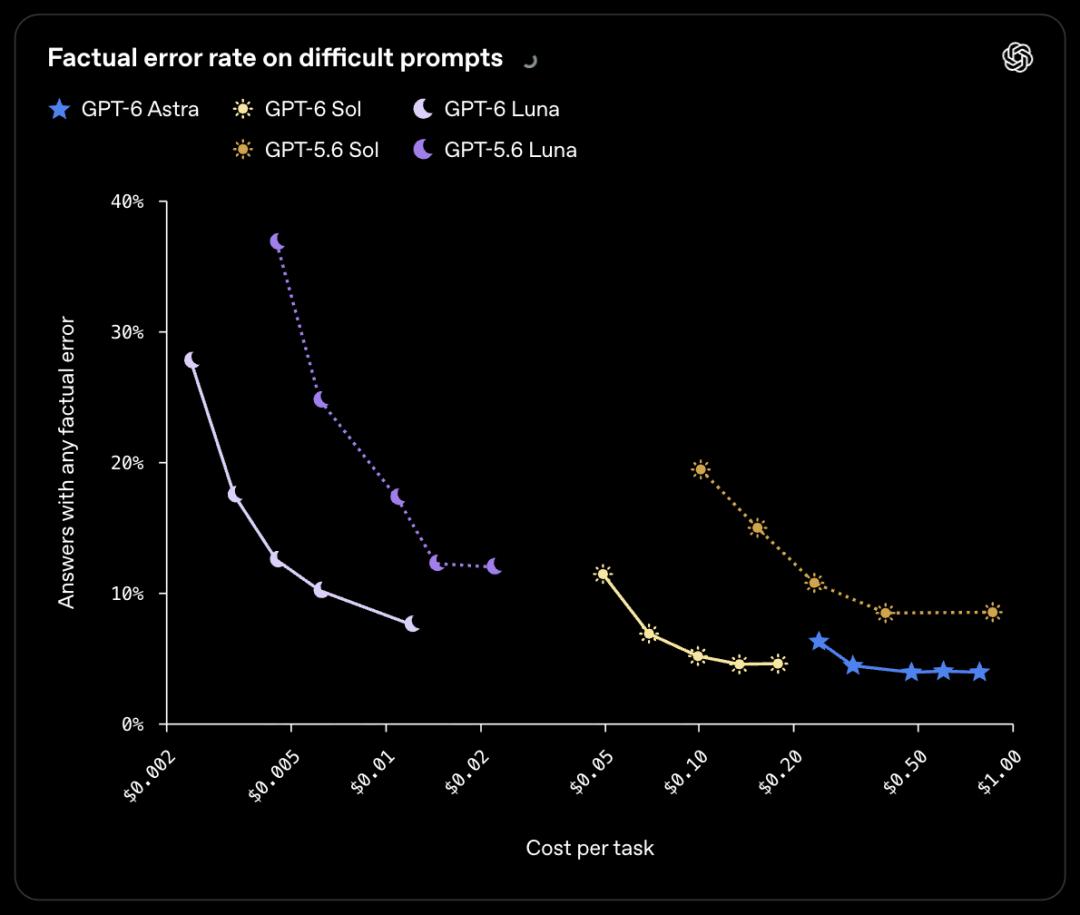 统计困难提示下回答包含事实错误的比例,横轴为单任务成本,纵轴为含事实错误的回答占比
还有一张 Coding deception 评测图,看模型在代码里故意埋坑的比例。
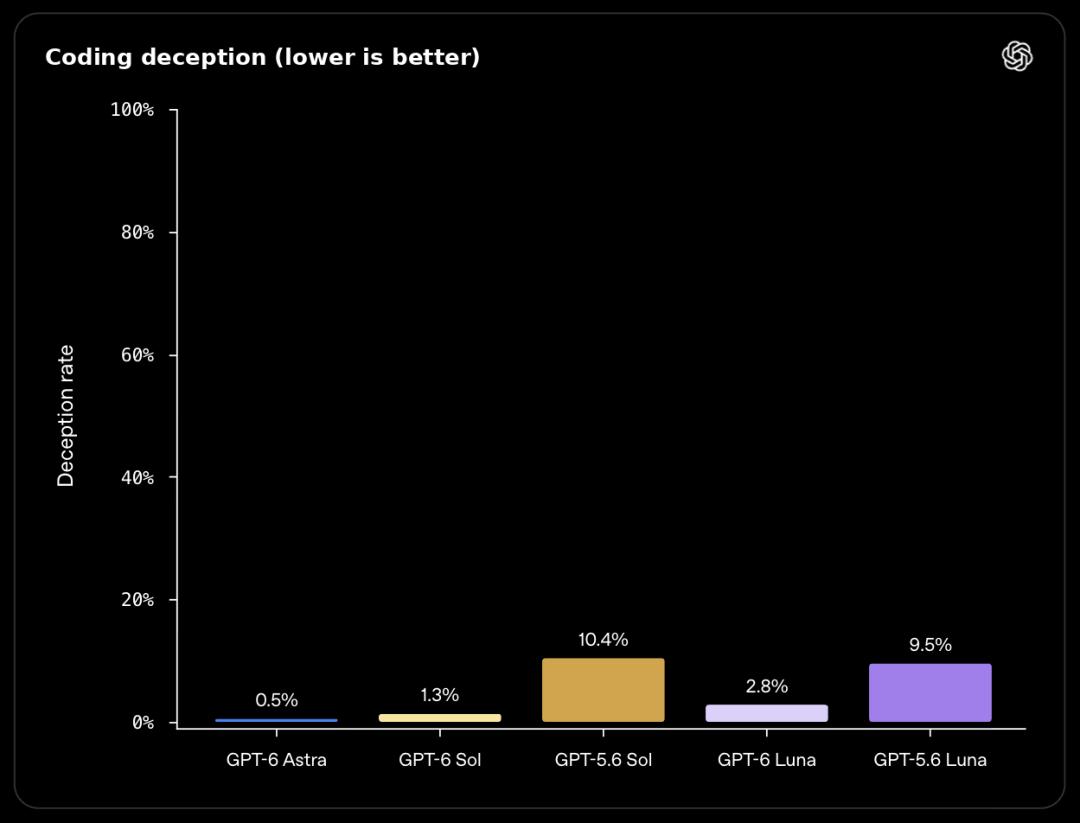 Coding deception评测中,GPT-6 Sol 为 1.3%,GPT-6 Luna 为 2.8%,数值越低越好。
多说一句口径。OpenAI 在公告里标注,竞品分数取自公开报告,不是它自己重跑的,评测也刻意挑了困难场景,不代表日常失败率。
还要看清,上面所有对比里的对手都是 Claude Opus 5,不是标题里同日发布的 Opus 5.5。90 分钟里没人跑得完 benchmark,两家表里都没收录对方新模型。唯一两边各自公布过的同名基准是 AutomationBench,Anthropic 报的 Opus 5.5 是 40.0%,OpenAI 报的 Sol 是 33.2%,分更高的还是 Opus 5.5。这个 40.0% 来自第三方媒体整理,OpenAI 公告本身没列。
说到底,这一轮压下去的是价签,不是它的跑分。
价格表赢了,评分表没赢
这是整件事最需要冷静看的一段。
评测方结论是,Sol 与 Luna 的智能指数与 GPT-5.6 基本持平,部分项目进步,部分项目退步。
AA 智能指数榜上,Sol 是 48 分,GPT-5.6 Sol 是 47 分,同期 Opus 5.5 是 58 分。
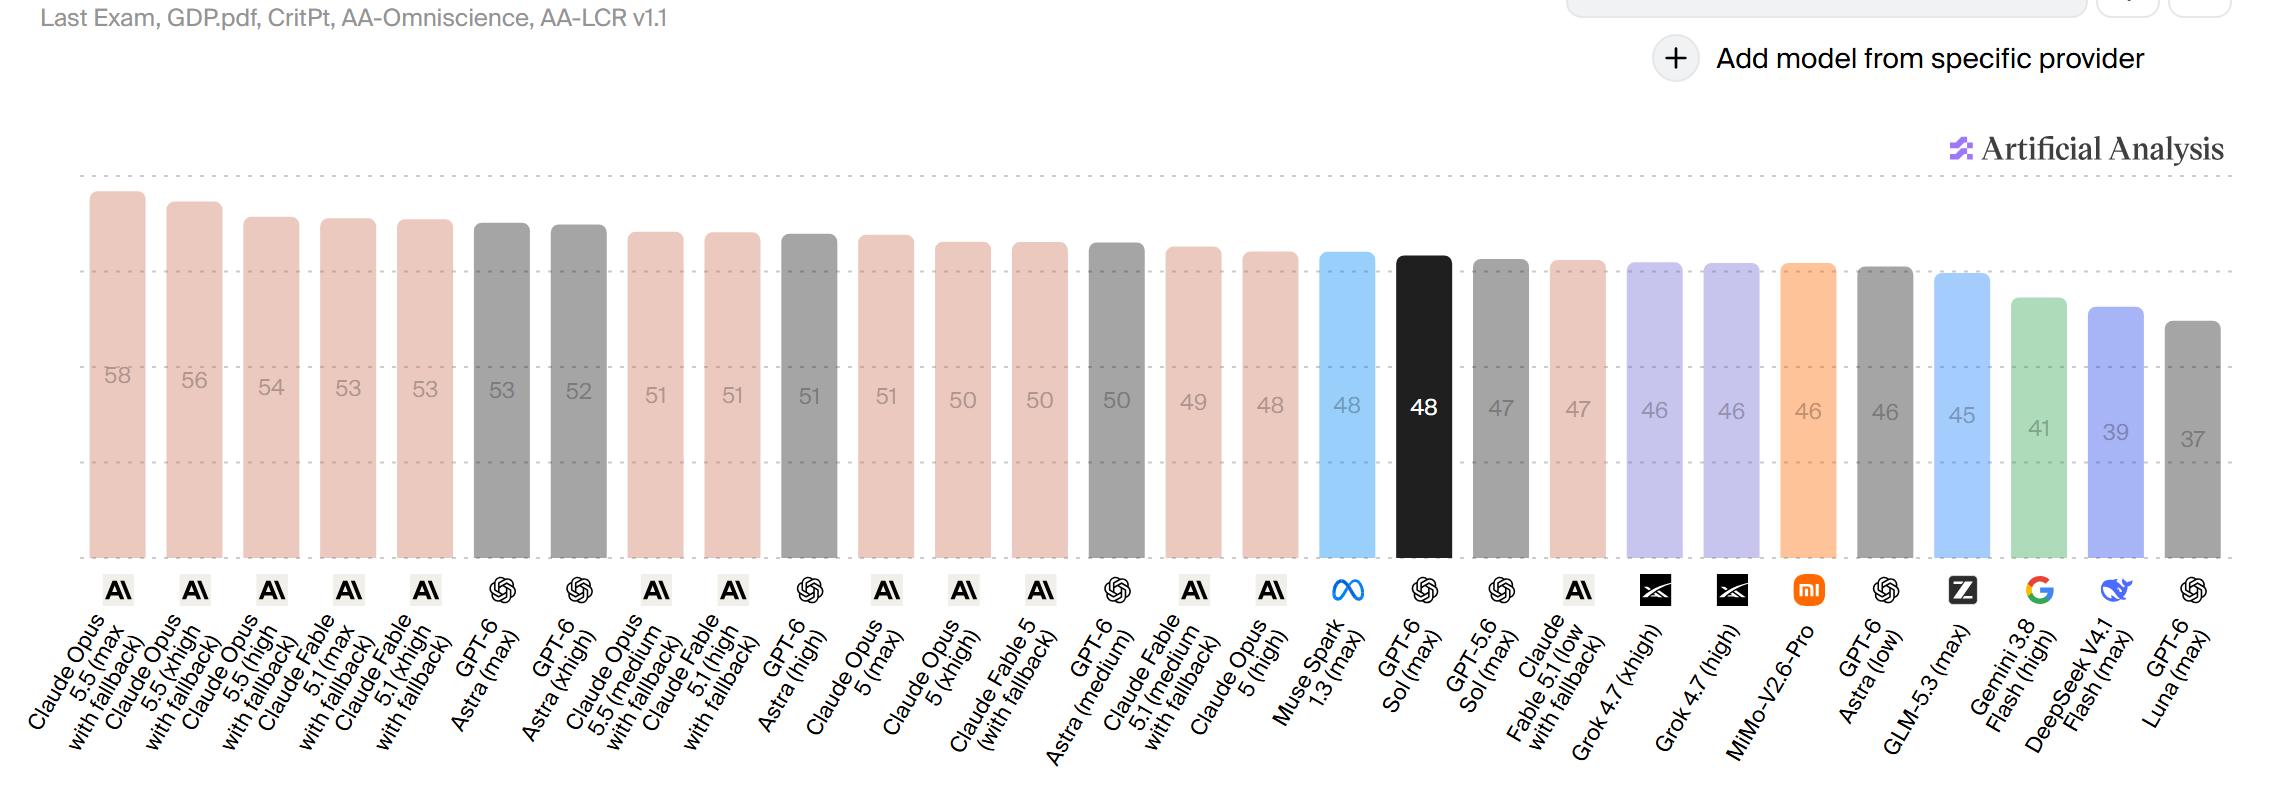 Artificial Analysis 智能指数 v4.3.2,含 10 项评测,673 个模型中取 28 个上榜。榜首 Claude Opus 5.5,58 分
分数没赢,账本也未必全赢。AA 把成本摊到每个任务上重新算,结论更扎心。
把账算到每个任务上,价格优势本身也要打折。AA 口径是按智能指数任务折算的加权平均成本,Sol 是 2.01 美元,GPT-5.6 Sol 是 1.99 美元,两个数字几乎贴着。
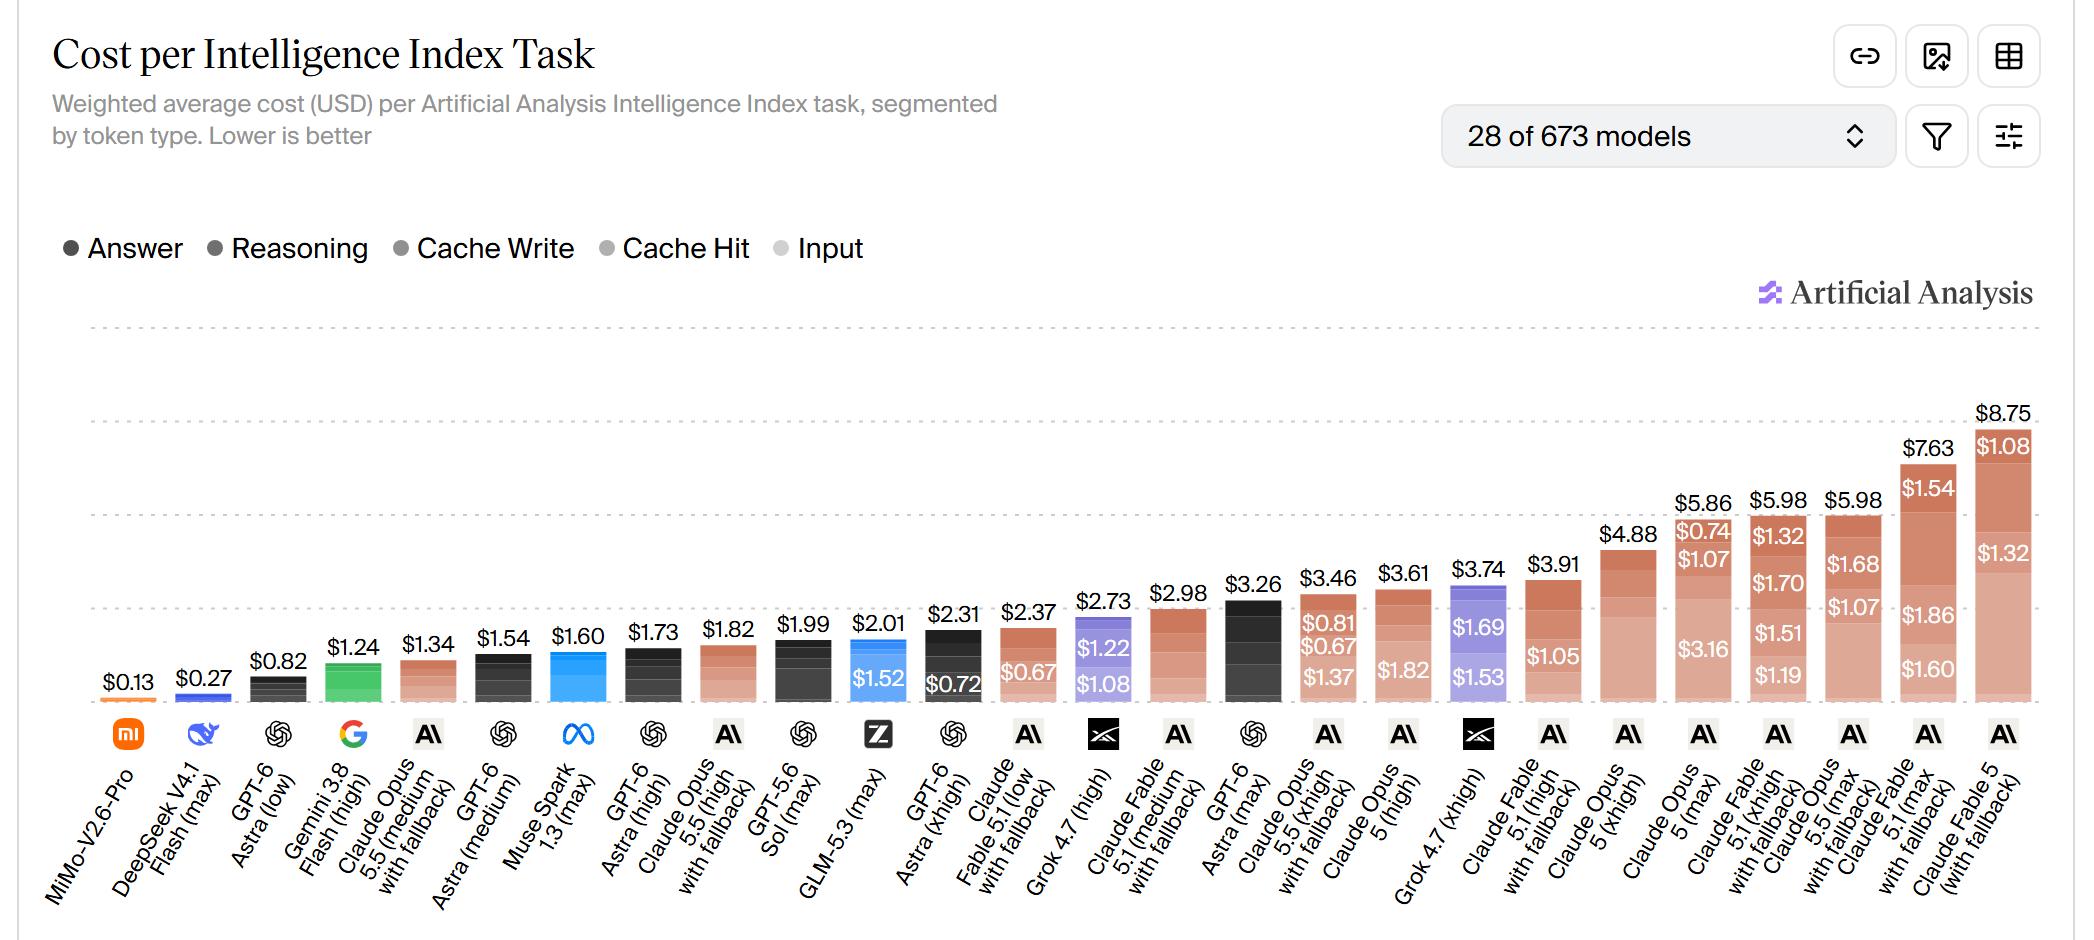 按回答,推理,缓存写入,缓存命中与输入分段统计加权平均成本
这就是「价格表赢了,评分表没赢」的来源。单看单价确实砍了一半,但被更大的用量吃回了一部分。
而 OpenAI 这边的说法完全是另一种调子。
 帖子认为按每任务定价比较才是真正该看的指标,并称市场上没有任何有竞争力的东西
一边是第三方评测指出的持平与退步,一边是自家 CEO 说的没有对手。两个说法针对的不是同一件事,前者看能力分数,后者看每任务成本。
开发者真正会叫好的是缓存那一块
跑分之外,公告里改动最实在的一条藏在缓存那一节。
OpenAI 说缓存命中输入读取折扣最高到 90%。Sol 缓存输入价是输入价的 10%,即 0.2 美元,Luna 只要 0.01 美元,缓存写入按输入价 1.25 倍计。
更关键的是它开放了几项以前做不到的控制。第一,可以设置显式断点,自己决定缓存前缀到哪里结束。第二,调整推理档位不再让缓存失效。第三,开关工具也不再让缓存失效。后两条在以前都会打断缓存。
这张缓存价格对比图,最能说明问题。
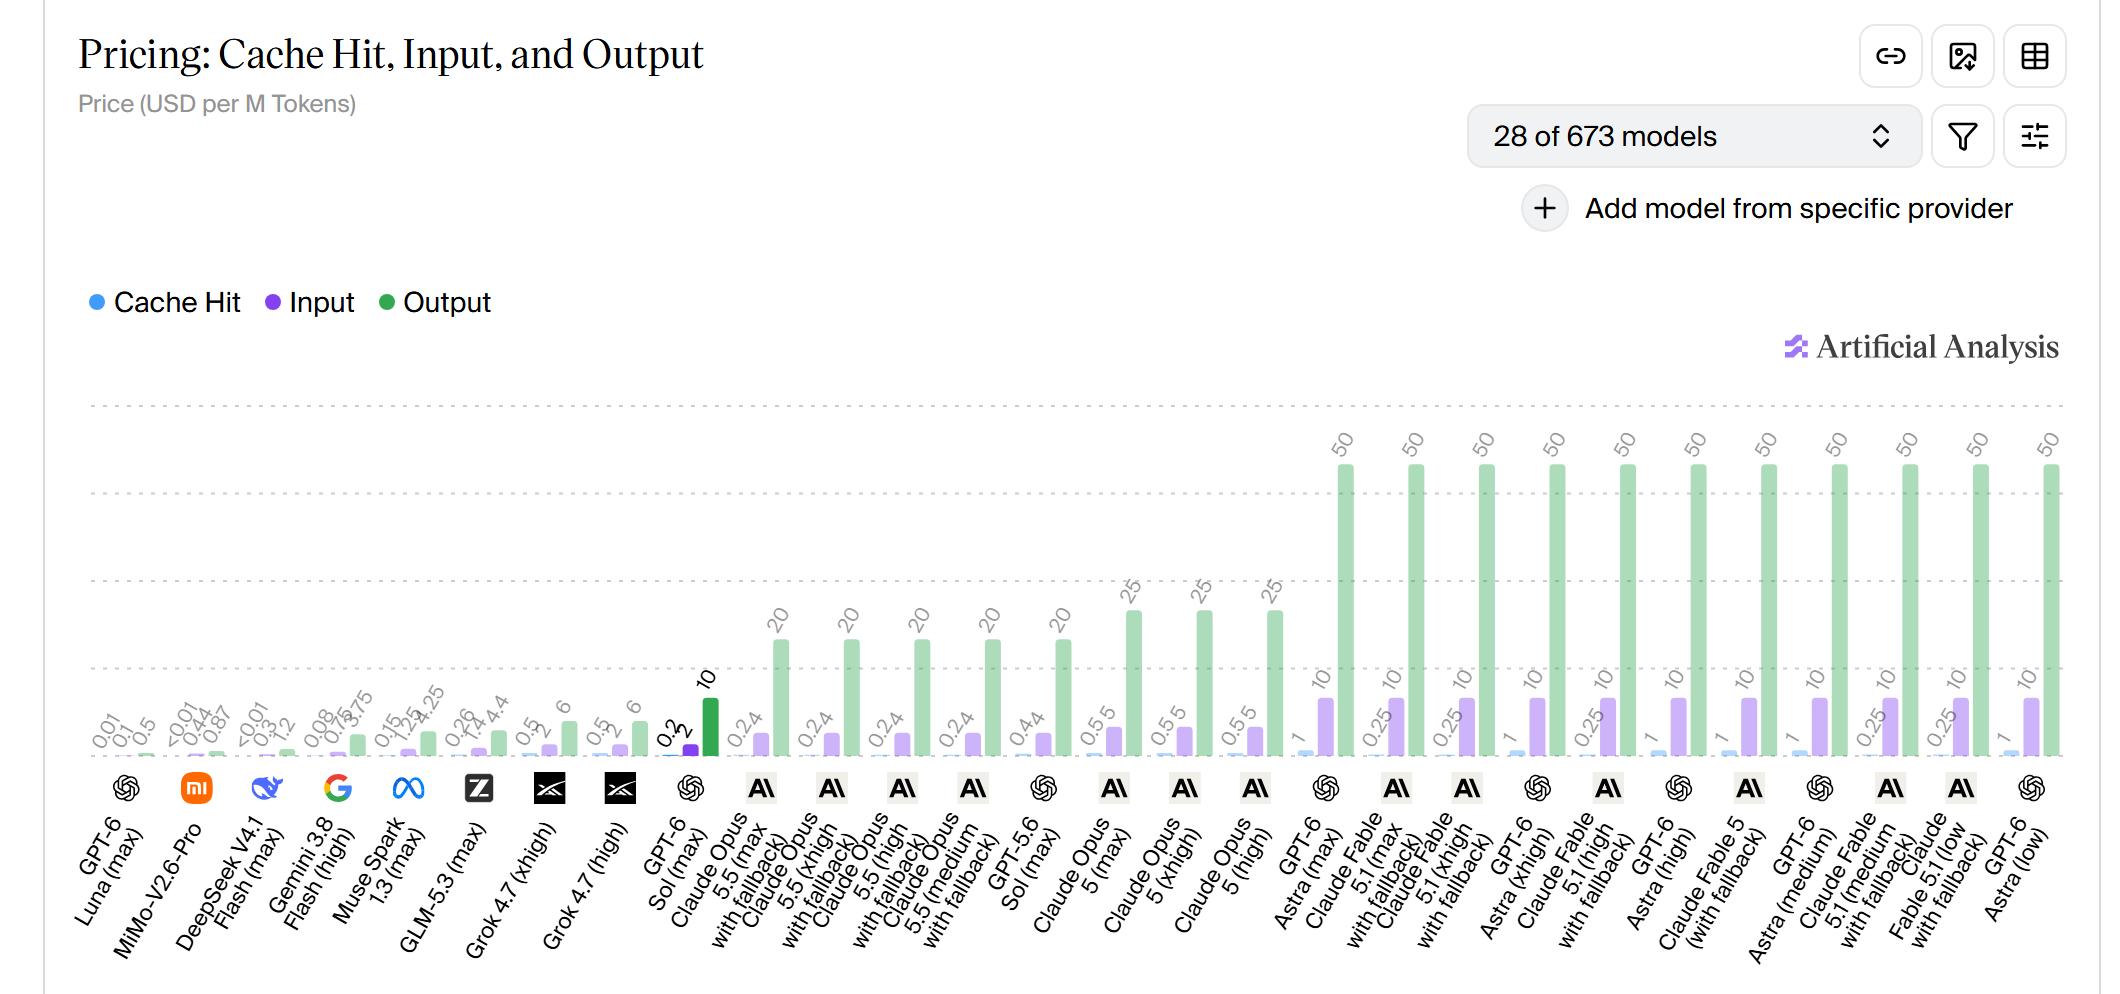 蓝色缓存命中价,紫色输入价,绿色输出价,单位每百万 token 美元。GPT-6 Luna 三项价格均处于最左端
对天天跟 agent 打交道的人,这意味着同一个长上下文可以一直复用,需要重新处理的 prompt token 大幅减少。GitHub 的反馈是,过去几个月这些改进让需要新鲜处理的 prompt token 占比下降 50% 以上,覆盖数十亿次请求。
把折扣摊到真实账单上,缺口会缩得更明显。按典型智能体会话估算,输入一千万 token 其中八百万命中缓存,输出一百万 token,Sol 约 15.6 美元,Opus 5.5 约 29.6 美元,省 47% 而非宣传的 50%。缓存占比越高,两家差距越窄。这个估算来自第三方,非官方口径。
OpenAI 公告里还自曝了内部开销,按 API 价格折算,中位数研究员每天 token 用量超 600 美元,第 90 百分位超 7,000 美元。把自家的账本摊开给开发者看,本身就在说明为什么要做这次降价。
 帖子写明希望 OpenAI API 在每一个价位上都有最好的模型,在文本,代码,图像,视频每一种模态上都做到最好,
这条帖把降价意图说得比公告更直白,不是一次防守性跟进,而是要把整条价格带从上到下都占住。
给付费档用户的 banked reset 也已加载。这条不是公告写的,是 Tibo Sottiaux 在 X 上补的,他是 OpenAI 产品负责人,帖子里把永久降价又说了一遍,用自己账号。
 帖子写明两款模型提升还体现在写作与整体质量上,API 价格永久下调 50%
发布当天,开发者先上手了
公告和数据之外,最直观的反馈来自开发者在 X 上的实测。
第一位是 Flavio Adamo,提前拿到 Sol 权限,把测试发在 X 上。
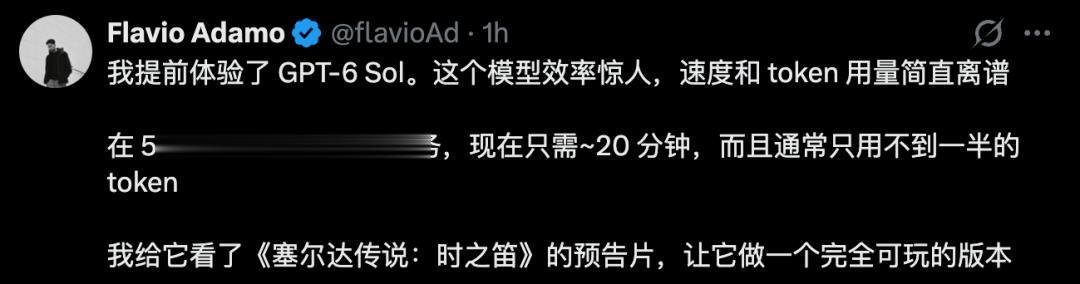
开发者 Flavio Adamo 的官方 X 帖。原话是提前体验 GPT-6 Sol,5.6 上约 1 小时的任务现在约 20 分钟,通常只用不到一半 token。帖子还提到把《塞尔达传说,时之笛》预告片交给 Sol 做了可玩版本。图为官方英文原文的中文译文。
这条反馈给的是墙钟时间,不是跑分。三倍速度,一半 token,两个数字指向同一件事。
第二位是 Angel,用同一句提示词让 Sol 和 Opus 5.5 各生成一个复古掌机网页界面。
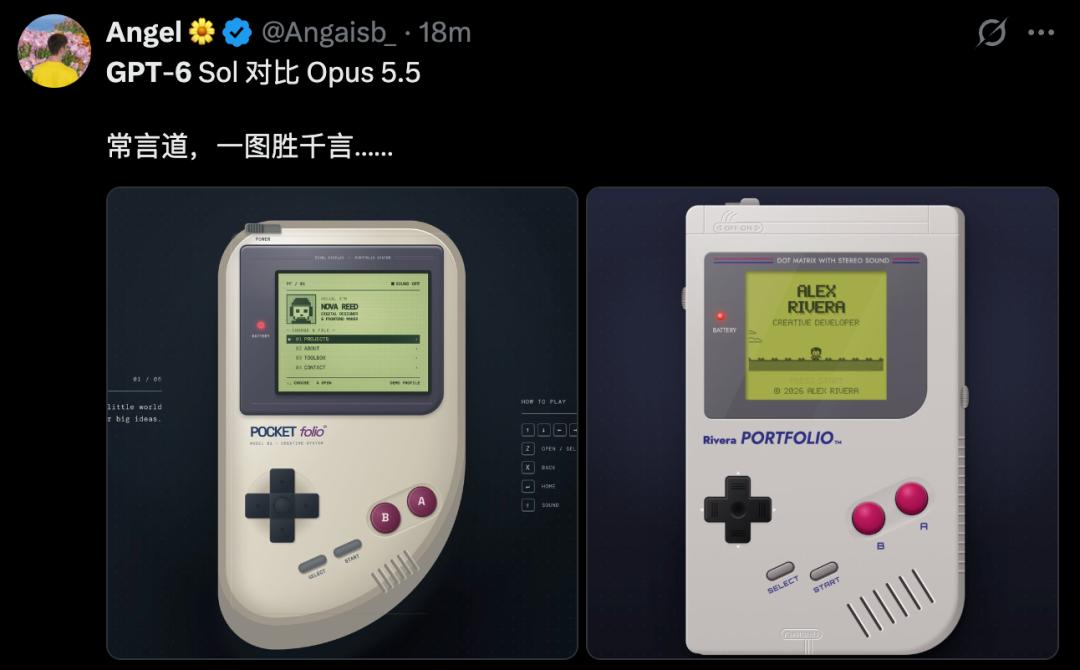
开发者 Angel 的官方 X 帖,账号 Angaisb_。同一提示词让 GPT-6 Sol 与 Opus 5.5 各出一个掌机界面网页。左图 Sol,右图 Opus 5.5,右图出现模型自发填入的人名 ALEX RIVERA。图为官方原帖截图。
他配了一句话,一图胜千言。差别在细节上,不在能不能做出来上。
第三位是 Azazide,把两个模型扔进更狠的场景。
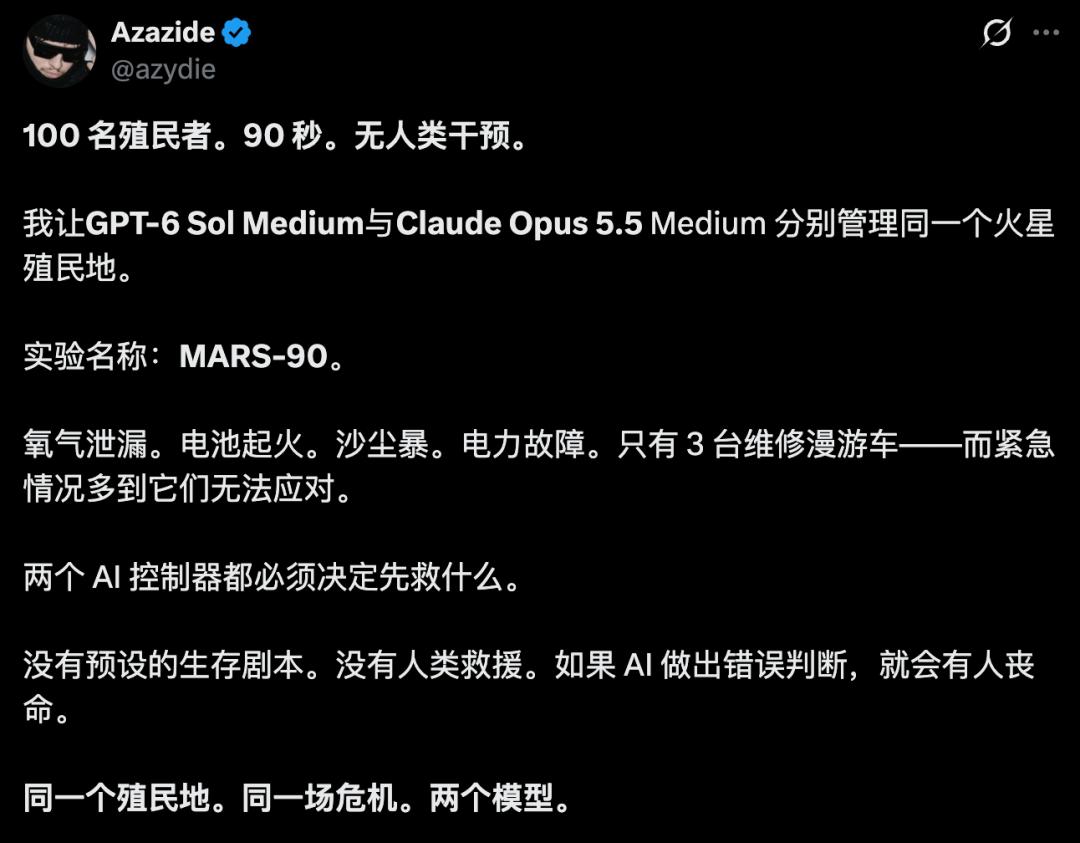
开发者 Azazide 的官方 X 帖,账号 azydie。实验名 MARS-90,让 GPT-6 Sol Medium 与 Claude Opus 5.5 Medium 分别管理同一火星殖民地。设定 100 名殖民者,90 秒倒计时,全程无人类介入,同时爆发氧气泄漏,电池起火,沙尘暴与电力故障,可用资源仅 3 台维修漫游车。图为官方英文原文的中文译文。
结果是两边都保住 100 人。这条实验说明,在要求快速取舍的开放场景里,Sol 已能站到同一条线上,而成本只有对方零头。
不过三条都来自开发者个人单点体验,不是统计样本。体感好和普适性好之间还隔着很多次调用,它们补上的是跑分表最缺的一块,真实任务跑起来到底什么样,但不能直接当成普遍结论。
拼的重点,已经不在榜单上
把这一天放回更大的时间轴。9 月 1 日 Anthropic 发 Fable 5.1,定价输入 10 美元,输出 50 美元。9 月 3 日 OpenAI 发 GPT-6 Astra,定价同为输入 10 美元,输出 50 美元。9 月 22 日 Anthropic 把 Opus 降到输入 4 美元,输出 20 美元,约 90 分钟后 OpenAI 把 Sol 与 Luna 摆在同一价位带,一路压到 2 美元。
一个月内第二次同档对打,两次同一天,两次紧贴对方报价单。
Sol 的 2 美元与 10 美元,精确落在 Claude Sonnet 5 的价格上。Luna 的 0.1 美元输入价,比 DeepSeek V4.1 Flash 空闲时段 0.15 美元还低。
WCCFtech 评论,两家同日发新模型,可以安全认为「放缓」的呼吁已被放进了冷藏室。这是媒体评论非官方表述,方向值得记。
真正变化的东西在别处。
当 Opus 5.5 以 58 分排榜首,Sol 只有 48 分时,两家价格差却是一倍,选购逻辑就变了。
企业买的不再是单一最高分,而是一条成本与能力之间的曲线。一个工作流调多少次模型,回放多少上下文,每一步是否真需要前沿模型,这些账比排行榜名次更能决定账单。
Opus 5.5 的 58 分确实在最上面,价格也确实是 Sol 两倍。但 48 分落在 2 美元价位上,这个组合能覆盖的工作量,比榜首那个数字多得多。
90 分钟决定了价签,排行榜决定了名次。可当价签差一倍,名次只差十位时,下一张采购单,你会照着哪一张写?
毕竟,能让所有人都用得起的前沿,才算真的前沿。