主题:端侧智能体架构 —— 从 NVIDIA「SLM 是 Agentic AI 的未来」论纲,到 Apple AFM 3 / Android AICore 双寡头平台战、BFCL 工具调用能力地板、SLM-First 路由模式与端侧经济学
一、报告概览
本期核心问题:AI Agent 的默认运行位置正在从云端向端侧迁移。本报告回答四个问题:
为什么小模型(SLM)足以承担 Agent 循环中的大多数步骤?
Apple 与 Google 在 2026 年各自交出了怎样的端侧 Agent 平台答卷?
端侧模型做工具调用的能力边界在哪里(BFCL 地板线)?
SLM-First 混合路由架构如何设计,经济学账怎么算?
研究方法:基于 NVIDIA arXiv:2506.02153(v3,2026-09-22 更新)、Apple Machine Learning Research(AFM 3 技术报告)、Android Developers Blog(AICore Developer Preview、AppFunctions/Android MCP 系列)、Berkeley Function Calling Leaderboard 公开结论及多方 2026 年工程实践报告的综合分析。
二、范式转移:为什么 Agent 的默认位置正在下沉到端侧
2.1 NVIDIA 论纲:Agent 循环里的工作是「窄而重复」的
2025 年 6 月 NVIDIA 研究员 Belcak 等人发表立场论文《Small Language Models are the Future of Agentic AI》(arXiv:2506.02153,2026-09-22 更新至 v3),给出一个关键行为学观察:
核心论点:在 Agentic 系统中,语言模型并不做开放式推理,而是在重复执行少数几种窄任务——路由输入、抽取字段、决定调用哪个工具、格式化调用参数、总结结果。「语言模型以少量变化重复执行少数专业任务。」——因此专用小模型常常能匹敌甚至超过通用大模型,且必然更经济。
这个论纲在 2026 年得到了供给侧的呼应:一个深厚的端侧模型梯队(Phi-4、Gemma 3/4、Qwen3、Llama 3.2、SmolLM2、Nemotron Nano)+ 成熟运行时(Ollama MLX 后端、Apple Foundation Models、Android AICore),使「在消费级硬件上跑 Agent」从极客玩具变成了工程现实。
论文对 SLM 的定义是实用主义而非参数主义的:「能在常见消费设备上运行、响应速度快到足以服务单个用户请求的语言模型」——按 2026 年硬件行情映射为 3–10B 参数带。这个定义刻意排除了 30B+ 的「伪小型」MoE(需要正经 GPU)。
2.2 三重驱动力

驱动力
2026 年现状
对 Agent 的意义
模型压缩
QAT 量化感知训练成为标配:Gemma 3 4B 从 8GB→2.6GB,1B 从 2GB→0.5GB,质量损失仅几个点
手机/笔记本内存预算内可跑可靠工具调用
NPU 硬件
Apple ANE、Google TPU Edge、Qualcomm Hexagon/Snapdragon NPU 均达数十 TOPS,功耗 <5w 每步 agent 循环数十毫秒级出 token,无网络往返 隐私合规 gdpr hipaa 数据本地化法规:数据不出设备="推理层无需" dpa、无需跨境传输分析 医疗 法律 金融 的原生合规优势 2.3 平台级里程碑:2026 年端侧 AI 从「研究演示」变成「无聊的基础设施」
2026 年的关键变化不是某个模型更强,而是端侧 AI 成为平台标配 API:Apple 向第三方应用开放了 Apple Intelligence 的端侧语言模型,Google 的 Gemini Nano 通过 AICore 系统服务内置于 Pixel/Samsung 设备——开发者调用它,而不需要打包或训练自己的模型。模型住在 OS 层,不在 App 二进制里。
三、双寡头平台战:Apple AFM 3 vs Google AICore/Gemini Nano
3.1 Apple:第三代基础模型(AFM 3)与「五模型家族」
Apple 在 WWDC 2026 发布了第三代 Apple Foundation Models——一个与 Google 合作定制的五模型家族,横跨端侧与 Private Cloud Compute(PCC):
模型
位置
规格
职责
AFM 3 Core
端侧
3B 稠密
通用端侧智能(人评偏好 45.6% vs 上代 23.3%)
AFM 3 Core Advanced
端侧
20B 稀疏,每次激活仅 1–4B
最强端侧模型,原生多模态(表现力语音、高精度听写),仅最高端 Apple Silicon 可用
AFM 3 Cloud
PCC
服务器主力
速度/效率/性能优化(人评偏好 64.7% vs 上代 8.7%)
ADM 3 Cloud (Image)
PCC
图像模型
Image Playground、Genmoji、照片编辑
AFM 3 Cloud Pro
PCC(NVIDIA GPU @ Google Cloud)
最强服务器模型
Agentic 工具使用与复杂推理
架构级创新——Instruction-Following Pruning(IFP):AFM 3 Core Advanced 打破了「所有权重必须驻留 DRAM」的传统约束。完整 20B 模型存放在 Flash(NAND)中;由于 NAND→DRAM 带宽不足以支撑标准 MoE 的逐 token 专家换入,Apple 改为按 prompt 粒度路由:轻量稠密块在初始处理时选定一组固定专家,生成期间周期性重选;配合高比例「常激活共享专家」+「按需换入的路由专家」,实现了远超 DRAM 物理限制的模型规模,且带来推理时弹性——按任务难度增量加载权重。
开发者接口(Foundation Models framework)三原语:
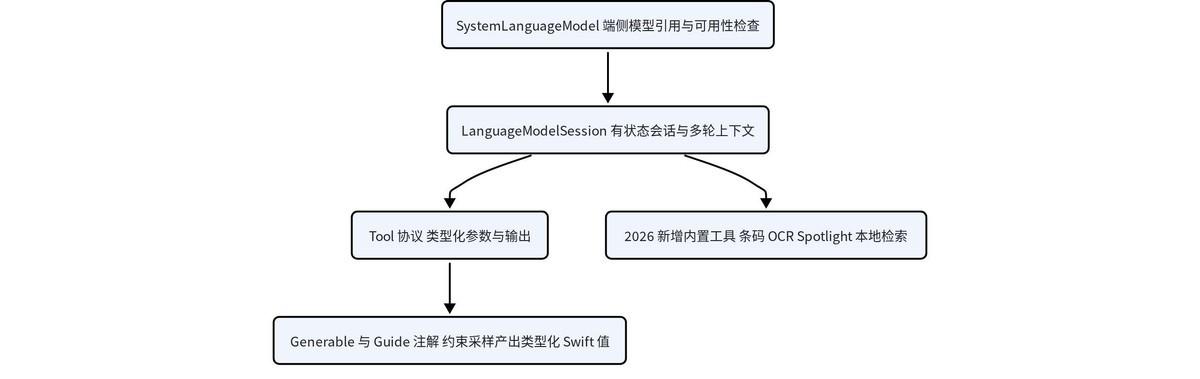
约束采样(constrained sampling):@Generable 结构体 + @Guide 字段注解使模型逐 token 生成时结构对齐 schema——结构非法的输出根本过不了边界,开发者拿到的是类型化 Swift 值而非 JSON 字符串,省掉手写解析器。
iOS 26 端侧模型上下文窗口固定 4096 token(指令+提示+输出合计);PCC 服务器模型升至 32K。
LoRA 适配器工具箱:开发者可离线(32GB+ Apple Silicon Mac 或 Linux GPU)训练 LoRA adapter 特化端侧模型。
2026 年统一调用点:端侧、PCC、第三方云被统一到单一 API 调用面——SLM-First + 升级模式被内建进平台。
Apple 的三协议路由问题(谁运行模型,决定了用哪个协议):
Foundation Models
你的 App 跑模型(端侧)
Tool 协议调你 App 自己的数据层
场景:App 内生成(周总结、食谱换算)
App Intents
Apple Intelligence 跑模型(系统 Agent)
Siri/Spotlight/快捷指令路由到你声明的 AppIntent
场景:「记 250ml 水」这类用户级指令
MCP
外部 Host 跑模型(Claude/Cursor/ChatGPT)
你的 App 暴露 MCP server,跨 JSON-RPC 被调用
场景:外部编码 Agent 伸进你的领域层
同一个冥想 App:App 内周报用 Foundation Models,Siri 记录用 App Intents,Claude Code 查询用 MCP——三个 runner,三种义务,一个共享领域层。
3.2 Google:AICore + Gemini Nano + ML Kit GenAI API + AppFunctions
Gemini Nano 现状(2026):
装机量超 1.4 亿台设备;v3 随 Android 17 发布(Google I/O 2026),号称「智能手机内出货过的最强端侧模型」
完全运行于 AICore 系统服务内,sub-second 延迟、全离线、零边际成本(无 API 计费面)
双硬件档位:Nano-1(1.8B,低内存设备)/ Nano-2(3.25B,旗舰),均 4-bit 量化
硬门槛:Gemini Intelligence(Nano v3 特性包)需要 12GB+ RAM 与当代旗舰芯片——连 Pixel 9 / Galaxy S25 都被挡在门外
上下文 4096 token(推荐 <1024)、最大输出 1024;无云 api、无 ios web 路径、无可下载权重 Gemini Nano 4 / Gemma 4(AICore Developer Preview,2026-04):
基于 Gemma 4 架构(E2B 极速档 / E4B 强推理档),为 Nano 4 打底;今天为 Gemma 4 写的代码将自动运行在年底的 Nano 4 设备上
性能:比上代快至 4 倍、省电至 60%;Gemma 4 QAT 后 E2B 以 LiteRT-LM 移动格式小于 1GB 加载,26B-A4B MoE 塞进 16GB 笔记本
新能力:CoT 推理、数学、时间理解(日历/提醒/闹钟场景)、图像理解(OCR/图表/手写体)
支持 140+ 语言;运行于 Google/MediaTek/Qualcomm 最新 AI 加速器
Preview 期将陆续补齐 tool calling、structured output、system prompt、thinking mode
ML Kit GenAI API 层(Prompt API 实战,官方 Jetpacker 示例):
行程摘要:prompt 迭代后响应从 13 秒 → 2 秒内(提示词工程在端侧同样值钱)
收据解析:@Generable Kotlin data(title/amount/category + @Guide 注解 + enumValues 约束)+ Structured Output API → 敏感财务数据全程本地
语音笔记:Speech Recognition API(Basic 模式覆盖 API 31+ 大多数设备;Advanced 模式用 Gemini Nano,当前限 Pixel 10)+ Prompt API 自动关联行程事件
工程细节:冷启动首次调用可长达 ~1 分钟(模型加载进内存),需后台预热;AICore Developer Preview 可绕过 BUSY 配额节流(但该开关是全设备级的,交付前必须关掉)
AppFunctions = Android 版「端侧 MCP」(1.0.0-alpha10,API 36+):App 通过 @AppFunction 注解暴露 Kotlin 函数,KSP 编译为类型化、沙箱化的工具定义;App 成为本地 MCP server,Android 平台是中央工具注册表,获得系统特权的 Agent App 作为 MCP client 注册后,可在后台发现并调用这些工具——「给巴黎行程加一笔 5 美元咖啡支出」无需解锁-开 App-翻页-拍照的 UI 流程,特权 Agent 后台直达。开发者完全控制暴露哪些功能,其余数据保持私有。这是端侧 Agent 生态最重要的互操作原语:MCP 从云端协议下沉为手机内的进程间协议。
3.3 双平台对照
维度
Apple Foundation Models
Google AICore/Gemini Nano
端侧模型
AFM 3 Core 3B + Core Advanced 20B 稀疏(IFP,NAND 驻留)
Nano v3(1.8B/3.25B)→ Nano 4(Gemma 4 E2B/E4B)
装机覆盖
iPhone 15 Pro+/M1+ Mac/iPad Pro
1.4 亿台(Pixel 8 Pro 起,v3 需 12GB+ RAM 旗舰)
开发者 API
Swift:Session/Tool/@Generable/约束采样
Kotlin:ML Kit Prompt API/@Generable(KSP)/Structured Output
上下文
4096(端侧)/32K(PCC)
4096(推荐 <1024) 4 系统 agent 入口 app intents(siri spotlight) appfunctions(特权 后台调用) 云升级路径 pcc(可审计、不存储、含 nvidia gpu 扩展) firebase ai logic(混合推理) 多模态 core advanced 原生多模态;ocr 条码内置工具 nano gemma 4:文本+图像+音频输入 计费 $0 端侧推理 端侧推理(硬件门槛替代价格门槛) 微调 lora adapter 工具箱(离线训练) 开放权重自托管替代 四、开放模型梯队与工具调用能力地板
4.1 端侧模型阵容(2026 年中口径,4-bit 量化后权重占用)
模型
参数
量化占用
上下文
原生工具调用
最低设备
Phi-4-mini(MIT)
3.8B
~3GB
128K
✅
4GB GPU / 8GB Mac
Gemma 3 1B(QAT)
1B
0.5GB
32K
有限
手机级
Gemma 3 4B(QAT)
4B
2.6GB
128K
✅
4GB GPU / 8GB Mac
Gemma 4 E2B
~2B
<1gb(litert-lm) 1 3 15 128k ✅ 手机(双平台) qwen3 1.7b 4b 1.7 ~1.1 2.6gb 32k ✅(qwen-agent) 4gb gpu llama 3.2 1b 3b ~0.7 2gb ✅(内置) 手机级 smollm2 1.7b(11t tokens) ~1.1gb ~8k 基础(框架中介) 6gb ram nemotron nano 4b(rl 专训工具调用) ~3gb apple afm core ~3b neural engine 芯片内 4k ✅(@generable) iphone pro+ 关键锚点:Phi-4-mini 以一半内存匹敌 Llama 3.1 8B 的全量 MMLU(73%);Qwen3-4B MMLU-Redux 83.7 击败两倍大的模型;ToolACE-8B 在 BFCL 总分上超过 GPT-4 与 Claude 3.5。
4.2 BFCL 地板线:工具调用在哪里断裂
Berkeley Function Calling Leaderboard 给出了端侧 Agent 最诚实的能力边界:
1–3B 是边缘设备可靠单轮工具调用的甜点带;低于 1B 的模型在多轮(multi-turn)、并行函数(parallel)、嵌套调用(nested)三种难形态上系统性失败。7–20B 微调后可匹敌甚至超越闭源系统。实践含义:这是一个路由决策而非单一模型选择——如果你的 Agent 需要并行或嵌套调用,不要部署 sub-1B 模型然后祈祷。
按任务形态分车道:
SLM 稳吃:schema 约束的结构化输出、字段抽取、响应归一化(1–4B 干净利落)——这是大多数工具调用的地基
SLM 吃力:多轮工具链、并行调用、长文档推理、开放域推理 → 升级云端
实测短板:sub-4B 端侧模型普遍在字符级精确任务上失手(独立测试对 Apple 模型与 Nano 的一致结论)
4.3 SLM-First 路由模式(local-by-default, cloud-on-escalation)

多份 2025–2026 实践报告:80–90% 的 Agent 任务步骤留在本地车道(经验法则,随负载与置信度阈值浮动)
置信度阈值按任务风险调:高风险流程收紧、成本敏感流程放宽;必须埋点监控升级率,知道多少流量真正离开了设备
延迟红利:端侧数十毫秒/token 无网络往返 vs 云侧每步数百毫秒——在循环里被逐轮放大
Apple 已把该模式做进平台(端侧/PCC/第三方云统一调用点);Android 用 Firebase AI Logic 做混合推理层
五、端侧经济学:Break-even 数学
以便宜的托管模型价($1/M 输入、$5/M 输出)、典型 Agent 步骤 ~2000 token(1500 in/500 out)≈ $0.004/步 计:
日 Agent 步数
纯云成本/天
纯云成本/年
vs $600 硬件回本
1,000
$4
$1,460
150 天
5,000
$20
$7,300
30 天
10,000
$40
$14,600
15 天
50,000
$200
$73,000
3 天
两个让账更悬殊的因子:
SLM-First 路由留下 80–90% 步骤在本地,实际云账单只是上表的 1/5–1/10
3–4B Agent 的「硬件」往往是你已经拥有的笔记本——capex 已沉没,回本即刻;笔记本 ~50W ≈ $0.14/天电费可忽略
而在双寡头平台上这笔账直接归零:Apple/Google 端侧推理无 per-token 计费,成本从「API 账单」变成了「用户的设备门槛」。规模化视角:把推理推到端侧,功能从几千用户扩到几百万用户不产生增量推理成本——这是云端 API 无法给出的可扩展性曲线。
六、约束、风险与安全新面
6.1 工程约束清单(被乐观叙事跳过的部分)
约束
细节
设计对策
可用性逐设备
老设备/禁用 AI 的设备返回 not-available
把模型当 feature flag 而非保证;UI 提前分支,备好无 LLM 路径
碎片化
能力取决于具体机型+OS 版本(Nano v3 连 Pixel 9 都不支持)
渐进增强 + 优雅降级,测试矩阵要预算
上下文窗口
4096 是硬预算(指令+提示+输出合计)
长文分块/摘要;工具返回引用(ID/key)而非全量 payload,下一轮按需重取
冷启动
首次调用可达 ~1 分钟(模型载入内存)
后台预热,别在首次交互时触发
配额节流
AICore BUSY 错误保护设备
Developer Preview 旁路仅限测试;生产要处理退避
非平凡延迟
工具链多轮不即时
流式 UI、不阻塞主线程、处理中途离开
模型随 OS 更新漂移
iOS 26.4 换模型即换行为
每个模型版本维护/回归 prompt
6.2 安全新面:端侧 ≠ 自动安全
隐私保证的边界:Apple 的端侧隐私承诺覆盖推理本身,不覆盖你写的 Tool 实现——如果你的工具自己发起网络调用,那归你的隐私政策管。
特权 Agent 是新攻击面:AppFunctions 模式下,获系统特权的 Agent 可后台调用 App 功能。KDoc 直接编译为工具 schema——文档即接口即攻击面,恶意/被注入的 prompt 经由系统 Agent 触达本地工具时,沙箱与权限最小化是最后防线。
升级路径的数据泄露口:SLM-First 架构中,只有升级轮次出云——可以按任务决定敏感内容是否允许升级,这是云端架构没有的控制粒度,但需要显式设计。
PCC 的范式意义:Apple 把「可验证隐私」扩展到 NVIDIA GPU@Google Cloud(AFM 3 Cloud Pro),用户数据不存储、不共享(含 Apple 自身)——端云混合的信任锚点从「不出设备」演进为「密码学可验证」。
七、研判与建议
研判
端侧 Agent 的「ChatGPT 时刻」不是模型时刻,是协议时刻——AppFunctions(Android MCP)与 App Intents 把「系统级 Agent 调用第三方 App 能力」标准化,其生态意义大于任何单模型升级
双寡头收敛于同一架构:小端侧模型 + 约束采样类型化工具 + 稀疏大模型弹性推理 + 可验证隐私云升级。Apple 的 IFP(NAND 驻留 20B)预示「存储换内存」将成端侧大模型标准解法
BFCL 地板线短期不会消失:sub-1B 多轮/并行/嵌套工具调用的系统性失败是架构性的;端侧 Agent 的产品形态将围绕「单轮结构化工具调用」收敛
推理成本的地理大迁移:80–90% Agent 步骤本地化后,云端前沿模型退位为「循环偶尔咨询的顾问」,Token 经济学重心从 API 定价转向设备渗透率
️ 建议
新 AI 功能默认先问「能否端侧」:延迟敏感/隐私敏感/离线必需 → 端侧优先;开放推理/长上下文/跨设备一致性 → 云。路由决策从第一天显式设计,降级路径先建好
工具调用按形态选模型:单轮 schema 填充 1–4B 足够;多轮/并行/嵌套 → 7B+ 微调或直接升级云端;不要用 sub-1B 硬扛
投资提示词工程与模型版本回归:端侧 prompt 迭代收益巨大(13s→2s 案例);OS 更新即模型更新,建立 per-model-version 的 prompt 回归测试
上下文预算当稀缺资源管理:工具返回引用不返回 payload;4096 窗口内指令+示例+历史的分配要显式规划
审计你的 Tool 实现:平台隐私承诺止于推理边界;工具内的网络调用、敏感数据升级出云的策略要逐条过安全评审
八、结语
2026 年端侧 AI Agent 的故事,本质是 Agent 基础设施的「下沉」:模型下沉到 NPU,工具协议下沉到进程间(Android MCP/AppFunctions),隐私保证下沉到硬件与密码学(ANE/PCC),成本曲线下沉到零边际。NVIDIA 的论纲——「SLM 足够强、天然更适合、必然更经济」——正在被 Apple 和 Google 用两亿级设备装机量验证。对 Agent 开发者而言,问题不再是「要不要端侧」,而是「哪些步骤留在本地,哪一轮升级出云」——这个路由决策,就是端侧时代的核心架构技艺。
参考来源
Belcak et al., Small Language Models are the Future of Agentic AI, arXiv:2506.02153v3(2026-09-22)
Apple ML Research — Introducing the Third Generation of Apple's Foundation Models(AFM 3 家族 / IFP / PCC-NVIDIA 扩展)
Apple Developer — Foundation Models framework 文档与 WWDC25/26 sessions(Tool 协议、@Generable、约束采样、内置工具)
Android Developers Blog — Announcing Gemma 4 in the AICore Developer Preview(2026-04)
Android Developers Blog — Build intelligent Android apps: On-device inference(2026-07,Gemini Nano 1.4 亿设备 / ML Kit Prompt API / Jetpacker 实战)
Android Developers Blog — Integrate into Android's intelligence system using AppFunctions(2026-07,Android MCP 架构)
Blake Crosley — Foundation Models On-Device LLM: The Tool Protocol(三协议路由分析)
Chatforest — Apple Foundation Models in iOS 27: Builder Guide(AFM 3 Core/Advanced、4096 上下文、LoRA Adapter)
Digital Applied — Small Language Models for On-Device Agents in 2026(模型阵容表、BFCL 地板、break-even 数学)
HokAI — Gemini Nano Guide 2026 v3(Nano v3 规格、12GB RAM 门槛、冷启动/BUSY 细节)
Wise Hustlers — On-Device AI in 2026(平台化转折点、混合架构立场)