从不确定到行动: 学习引导LLM代理
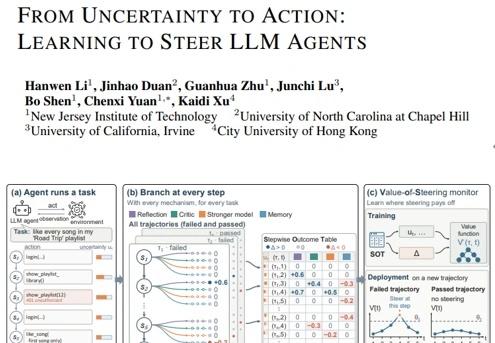
这篇论文着力解决如何利用不确定性信号来有效引导(steer)LLM智能体执行多步任务的问题,核心在于将不确定性转化为精确的干预决策,以提升任务执行效果并降低副作用。
具体而言,论文将这一问题分解为三个层面的决策,并指出现有方法未能充分回答:
是否引导(Whether):不确定性虽能在轨迹层面一定程度上识别即将失败的任务,但对成功轨迹的盲目引导反而可能引入错误、降低最终得分,因此需要权衡干预的收益与风险。
在哪一步引导(Where):不确定性信号无法可靠地定位“哪一步进行引导”最能改善最终结果。论文通过逐步反事实评估表明,检测失败的能力与定位最优干预步骤的能力并不一致,甚至相互背离。
用哪种机制引导(Which mechanism):不同引导机制(如自我反思、外部批评、更强模型辅助、基于记忆的指导)对“哪一步最有价值”的判断一致性很低,没有单一不确定性信号能同时适配所有机制并准确指出最优选择。
为系统性地研究上述局限,论文构建了逐步结果表(Stepwise Outcome Table, SOT),通过在每一步、每一种机制下进行反事实执行,测量引导对最终任务得分的真实影响(即Δm(τ,t)=S(τm,t)−S(τ))。基于SOT的观察,论文进一步提出VoS(Value of Steering),一个轨迹级别的监控器:它从所有不确定性信号中学习每一步引导的预期价值,并通过损害预算触发器(harm-budgeted trigger)限制对成功轨迹的干扰比例,从而在离线或在线场景下实现更优的引导决策。
综上,该研究试图回答的核心问题是:在多步LLM智能体执行中,不确定性是否能、以及如何被用于指导“是否干预、在何处干预、以何种机制干预”这三个关键决策,以实现比无干预执行更稳定、更显著的任务性能提升。
大模型 深度学习 科研学习 提供思路和创新点 科研