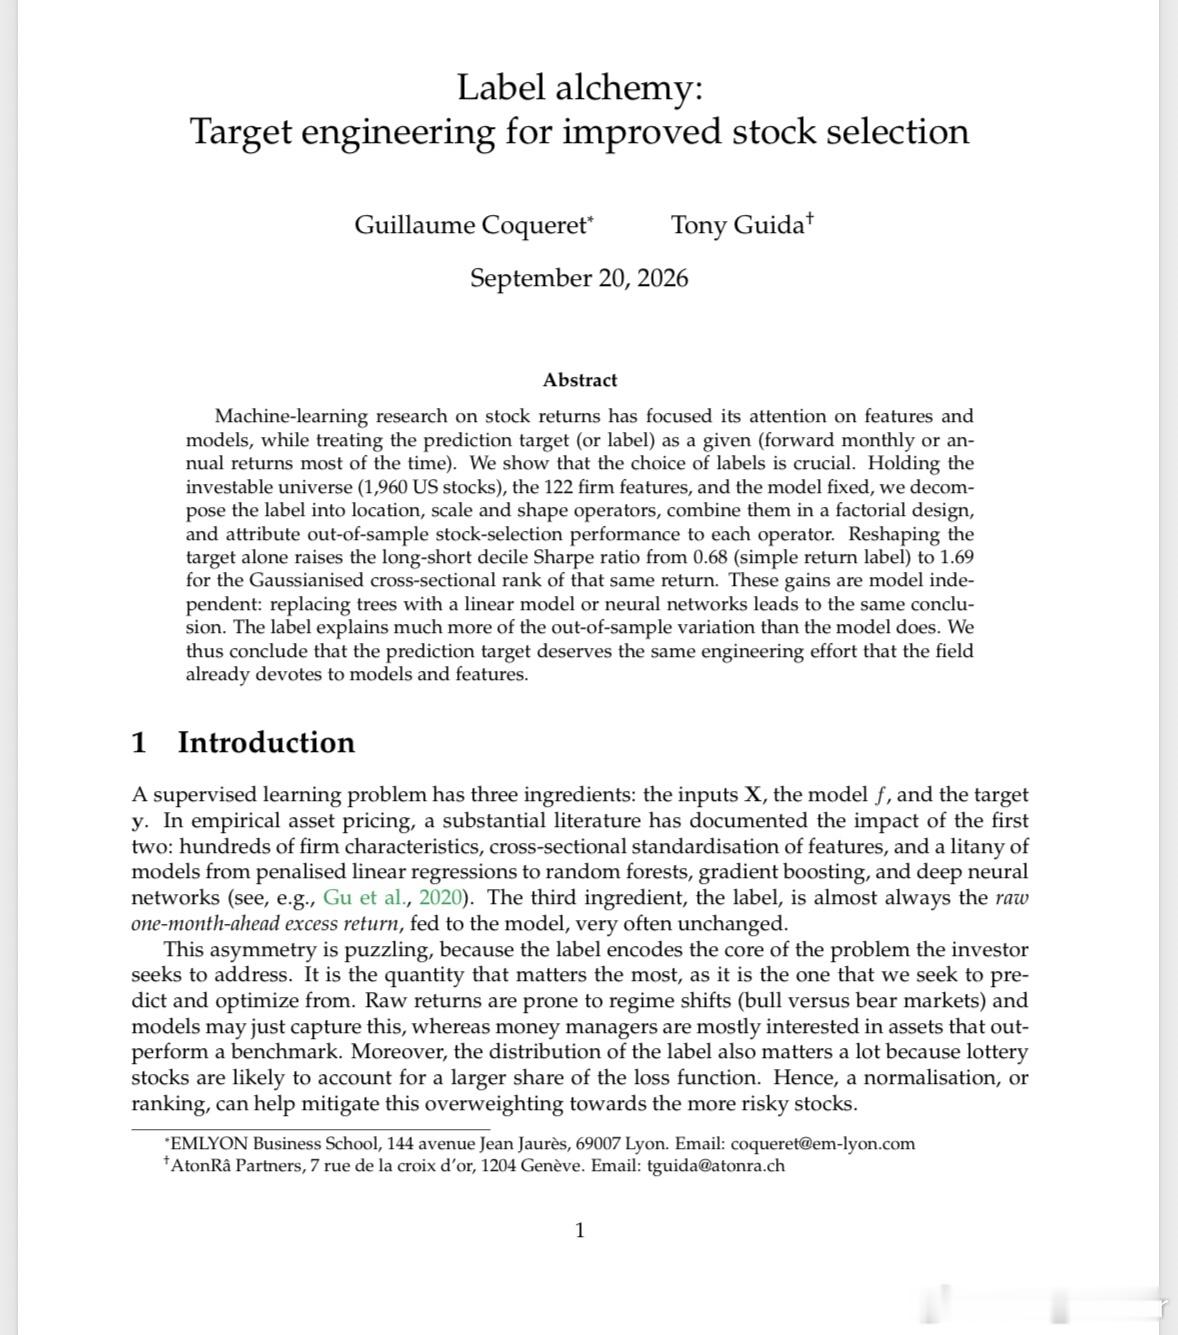
《Label alchemy: Target engineering for improved stock selection》总结
这篇论文的核心观点是:在机器学习选股中,预测目标(label)的选择和工程化与特征、模型同样重要,甚至可能更重要。作者批评现有研究大多只关注特征和模型,而默认使用原始的前瞻收益作为标签。
1. 研究设计
· 固定投资域:1,960 只美国股票,2002–2026 年,122 个公司特征。· 固定模型:主要使用 LightGBM;后续用弹性网和神经网络验证。· 将标签分解为三个可组合算子: · Location(位置/中性化):减去市场均值、行业中位数、PCA 拟合值、FF6 因子残差等。 · Scale(尺度):除以横截面标准差、MAD、个股已实现波动率等。 · Shape(形状):恒等、百分位排名、高斯化排名、符号二值化。· 系统组合出 30 个标签,重点分析其中 15 个,包括 5 个新标签:行业中性、PCA 残差、FF6 残差及其排名版本。
2. 主要发现
· 仅改变标签,样本外多空十分位组合的 Sharpe 从原始收益标签的 0.68 提升到高斯化横截面排名的 1.69;最佳标签可达 1.74。· 原始收益标签在 2021–2026 年甚至产生负 Sharpe,而标准化或排名后的标签表现强劲。· 全样本中表现最好的标签包括:rank_gauss(1.69)、sector_zscore(1.56)、zscore(1.53)、robust_z(1.46)。原始收益排名第 13/15。· 从原始标签到标准化/排名,收益提升最大;标准化能降低厚尾影响,减少极端公司-月对平方误差损失的支配。· 完整因子归因显示:短期限 Shape 最重要,长期限 Location 最重要,Scale 的边际贡献相对较小。· 个股波动率缩放表现较差,换手高且无法很好区分赢家;横截面标准化更优。· 因子中性标签(行业、PCA、FF6 残差)在多个期限有竞争力,尤其是横截面构建时。
3. 稳健性
· 1、3、6、12 个月期限下,领先标签排序稳定;标签工程效应在短期限最大。· 多重检验校正后,30 个标签中约 25 个仍显著;PBO 远低于 0.5;SPA 检验在 1 个月和 3 个月显著优于原始收益基准。· 100 个随机种子下排序不变。· 更换为线性模型或神经网络后,结论一致:标签解释约 87% 的样本外 Sharpe 变异,而学习器仅解释约 4%。· 特征重要性显示,标签主要重新加权损失,而非完全改变特征集;期限越长,慢基本面特征越重要。
4. 结论与启示作者认为,预测目标不应被视为给定,而应像特征和模型一样进行系统化工程。未来方向包括:净成本后的标签重排、在其他市场和频率上的复制,以及直接优化排序或分位数损失的学习目标。