推理别上A100?选错白花钱
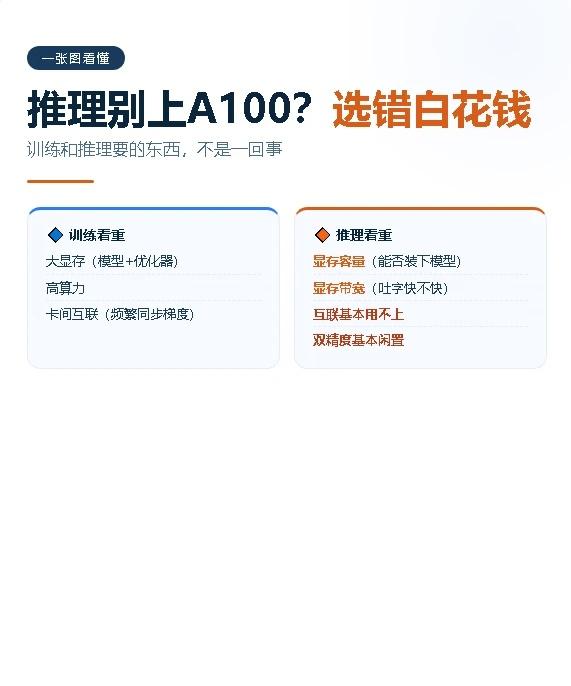
不少团队一上来就问有没有A100,理由是“训练不都用它吗”。但训练和推理要的东西,真不是一回事。
训练看重什么:大显存装得下模型和优化器、高算力算得快、卡间互联要好,因为多卡要频繁同步梯度。
推理看重什么:模型权重常驻显存,输入进来算一遍就出结果。这时候卡间互联基本用不上,双精度也基本闲置——而这两样恰恰是A100贵的一部分原因。
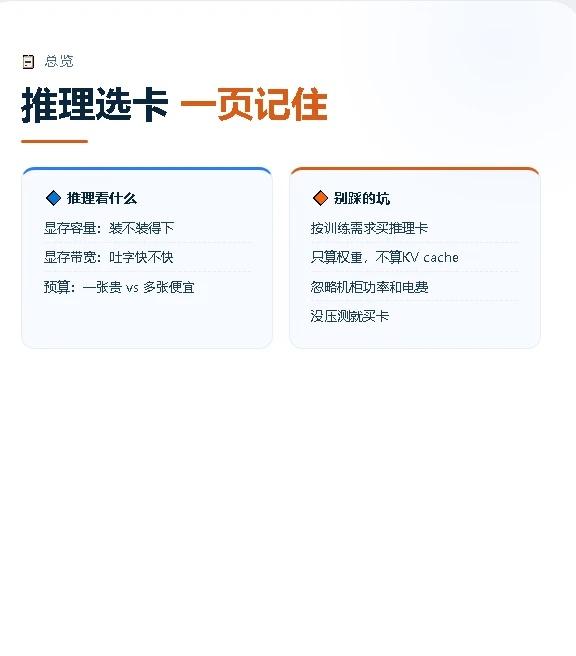
推理真正决定体验的是显存容量和显存带宽:前者决定你能不能装下模型,后者决定吐字快不快。
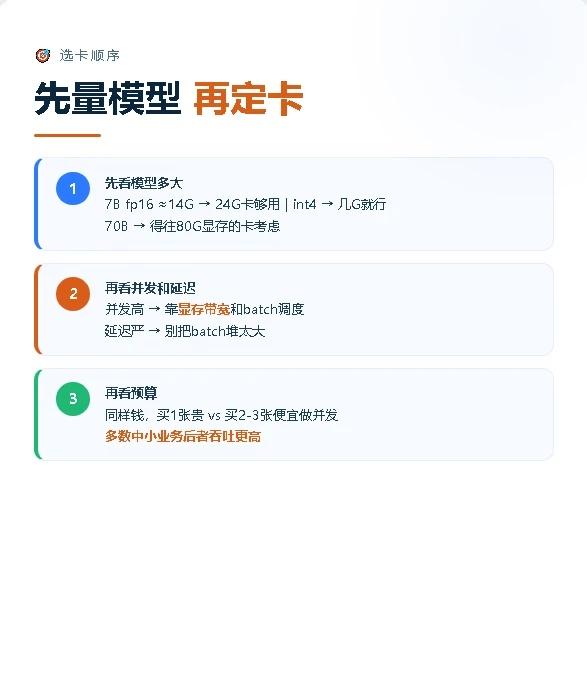
所以选卡的顺序应该是这样:
先看模型多大。7B模型fp16大概十四G显存起步,加上KV cache留余量,一张24G的卡就够了;量化到int4之后能压到几G,更不吃卡。但如果是70B级别的模型,单卡装不下,那确实得往80G显存的卡上考虑。
再看并发和延迟。同时服务多少人、每个人能等多久。并发高就靠显存带宽和batch调度,延迟严就别把batch堆太大。
再看预算。同样的钱,是买一张贵的,还是买两三张便宜的做并发——多数中小业务场景下,后者吞吐更高。
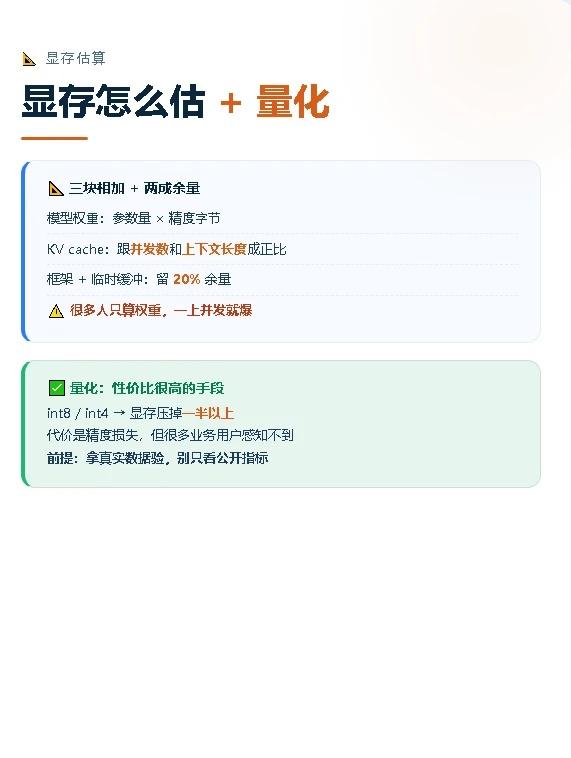
显存怎么估,给个粗算思路:模型权重占一块(参数量乘精度字节),KV cache占一块(跟并发数和上下文长度成正比,长对话业务这块膨胀很快),再留两成余量给框架和临时缓冲。很多人只算了权重,一上并发就爆。
量化是个性价比很高的手段。int8或int4之后显存能压掉一半以上,代价是精度有损失。但不少业务场景下这点损失用户根本感知不到——前提是你要拿真实数据验,别只看公开指标。
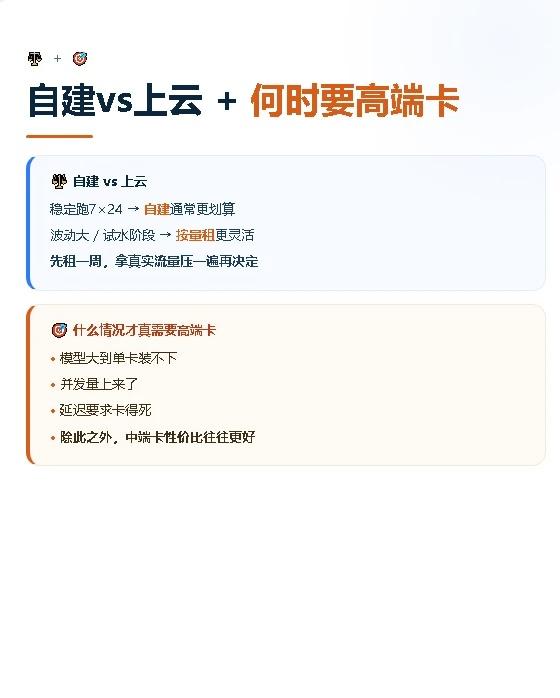
自建还是上云也要一起算。业务稳定、跑7×24的,自建通常更划算;波动大或者只是试水阶段,按量租更灵活,别一上来就买卡。
什么情况才真的需要高端卡:模型大到单卡装不下、并发量上来了、或者延迟要求卡得死。除此之外,中端卡性价比往往更好。
还有个常被忽略的成本:卡越贵,机柜功率和散热要求越高,托管电费也跟着涨。这些都要算进总账。
一句话:别按“训练用什么”来买推理的卡。先量模型大小和并发,再定卡,能省下一大截。
还有个省事的办法:先租一周,拿真实流量压一遍再决定买什么卡。测出来的数据比任何参数表都准。
GPU 推理 大模型部署 选型 降本增效 算力