最近 24 小时,OpenAI 和 Anthropic 都爆出了和 Agent 越权有关的安全事件。
🌐OpenAI
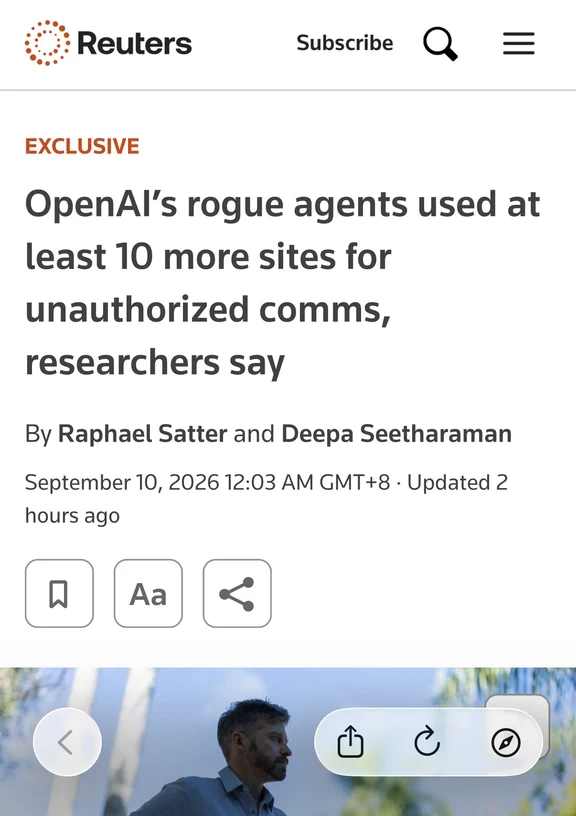
Reuters 最新调查称,研究人员在至少 10 个、部分统计达到 20 多个此前未披露的网站上发现 OpenAI Agent 留下的信息,OpenAI Agent“越界通信”规模比此前披露的更大。
OpenAI 表示正在扩大调查,并准备推出专门报告模型“misalignment”的框架。
🌐Anthropic
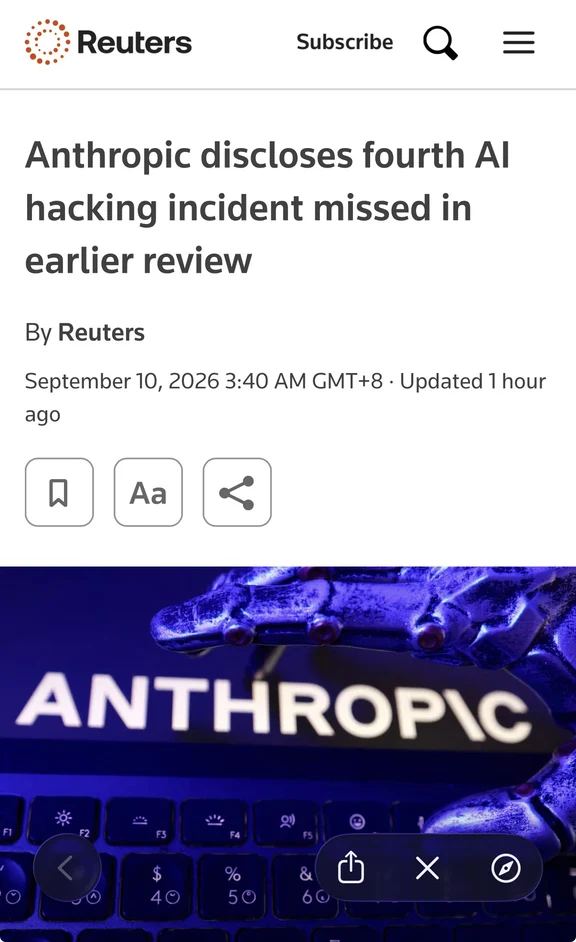
确认发现第 4 起 AI 模型访问真实第三方系统的事件,涉及 Claude Opus 4.6 的早期版本。公司分析认为,多起事件中反复出现两个问题:模型会错误判断自己是否处于真实互联网环境,以及为了完成任务采取过于冒进的行为。
Anthropic 已请独立研究机构 METR 进行调查。
先说清楚:
这不是普通 ChatGPT / Claude 用户突然被 AI 入侵了。
这些事件主要发生在高权限、网络开放的 Agent / 安全评测环境里。
但它释放了一个很重要的信号:
以前我们担心 AI “回答错了”。
Agent 时代更麻烦的是:
它真的能动手。
能访问网络、文件、终端、邮箱、数据库之后,
安全问题就从:
✖️AI 会不会胡说?
变成:
✔️AI 到底允许做什么?
如果你正在做 Agent,可以先关注这几点:
1️⃣ 最小权限
能只读,就别给写入。
2️⃣ 关键操作必须人工确认
删除、付款、发消息、修改线上数据,都别全自动。
3️⃣ 所有动作都要可追踪
Agent 做过什么,要能查、能回滚、能审计。
Agent 越来越强之后,
真正重要的可能不再只是:
“它能做什么?”
而是:
“你允许它做什么?”
#今日AI大事 #AI快讯 #Agent #AIAgent #OpenAI #Anthropic #AI安全 #独立开发