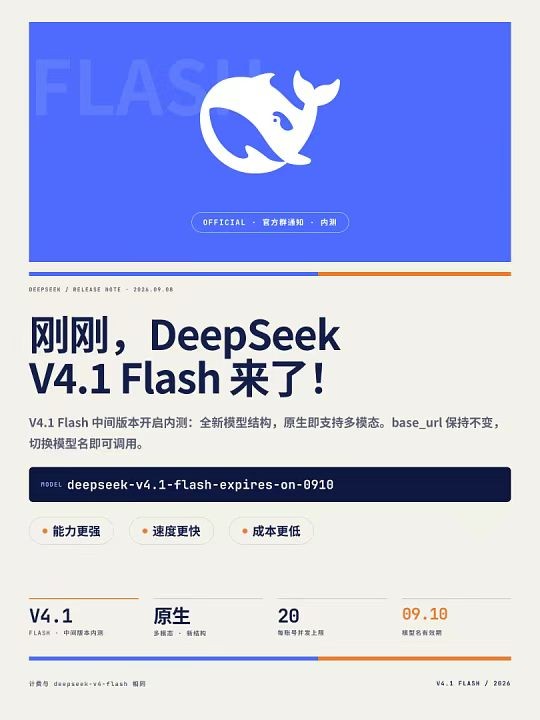
业内追踪大模型迭代,目光总落在参数规模、上下文长度、每百万token报价上。DeepSeek近期更新计费规则后,真正值得深挖的产业变化,藏在API账单一行不起眼的分类里。9月10日DeepSeek发布V4.1-Flash模型,API计费单独拆分缓存命中输入和缓存未命中输入两套定价。
按照官方人民币计费标准,高峰时段缓存命中输入每百万token为0.04元,未命中输入2元,输出8元。空闲时段价格减半,分别为0.02元、1元和4元。峰谷定价加上缓存分级计费,这套规则拆得很细。
单单这一项计费拆分,参考价值高于厂商常规宣传的参数升级。参数宣传会选取有利口径,账单的定价规则更能反映真实推理成本。更值得注意的是价差:缓存命中0.04元,未命中2元,差了50倍。这不是技术定价,是商业策略。DeepSeek在用50倍价差告诉开发者,系统提示词怎么写、对话结构怎么设计、前缀能不能复用,直接决定你的账单。推理成本优化从工程问题变成了产品设计问题。
这套定价背后是KV Cache机制。主流Transformer架构大模型采用自回归方式生成内容,每输出一个新token,都需要读取前文全部Key和Value完成注意力计算。KV Cache就是保存已经算完的参数,省去重复运算。对话上下文较短时,它只是一项性能优化。当模型进入128K长上下文阶段,智能体反复加载系统提示、工具定义、代码片段和历史对话,持续累积的上下文让KV Cache从优化小技巧变成左右运营成本的核心要素。
官方Hugging Face模型卡显示,V4.1-Flash全局KV缓存压到每token约890字节,约为V4-Flash的四分之一。官方同时披露新版本HBM显存占用降至原先的四分之一。这些是官方口径,具体部署中的实际占用还受并发量和序列长度影响。
过去评估算力实力,大家习惯统计GPU数量、浮点峰值这类硬件指标。落地真实推理业务,产业瓶颈已经转移。如何存储海量对话历史,如何搬运缓存数据,怎么减少重复预计算、提升缓存复用率,才是业务运营的关键。
不同存储介质各有取舍。HBM显存性能最强,单价高,容量有限。主机内存成本相对友好,资源却常常紧张。NVMe闪存容量充足,价格更低,读写速度有短板。网络分布式存储容量最大,数据延迟也最高。行业普遍采用分层调度方案,高频热数据就近放在GPU显存,中频温数据存入主机内存,低频冷数据下沉到NVMe或分布式存储。最难处理的是半热半冷的前缀缓存,迁移数据消耗带宽,留在显存又挤占空间。调度失当,要么拖慢响应,要么浪费显存。
今年多场行业峰会的方案都指向KV分层调度这个方向。FMS 2026技术峰会上,Supermicro、Penguin Solutions、Macronix等厂商围绕KV卸载、共享缓存、分层内存展开讨论。英伟达Dynamo公开文档已经将KV缓存视作可以跨卡跨节点调度的共享资源。苹果、谷歌、微软推出的提示词缓存方案思路相近。行业正在把对话历史缓存当成需要精细化管理的运营资产。
长上下文与智能体应用普及,单次请求的对话文本持续变长,KV缓存占用空间跟随序列长度和并发量同步上涨。HBM的容量和成本上限,无法承载无限膨胀的缓存。行业的解法是拆分缓存做分层存储,配套统一元数据、路由规则和失效清理策略,防止多轮对话读取异常数据。缓存命中率越高,重复预计算越少,算力开销和成本就越低。再搭配GQA、稀疏注意力、量化、前缀压缩等手段缩小单token缓存体积。
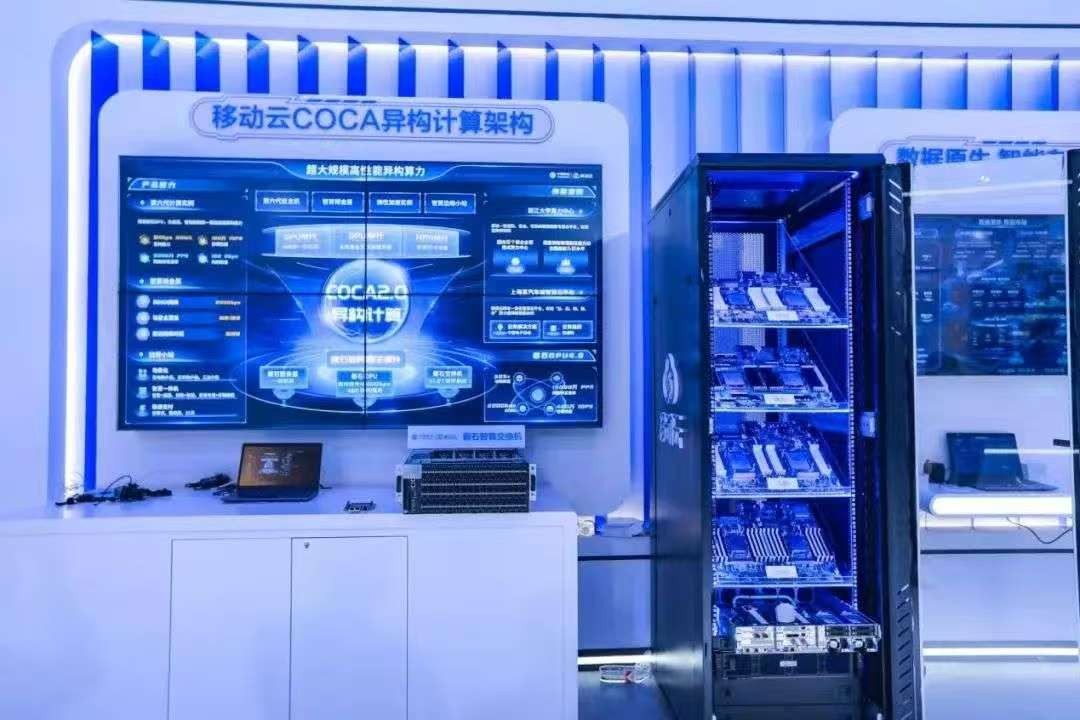
国内算力落地实践同样体现出这种精细化调度思路。9月中旬廊坊算力大会上,移动云发布GPU搭配类脑芯片的异构推理系统,把注意力计算交给国产GPU,前馈网络与MoE任务交由类脑芯片,依靠自研编译器与高速互联链路完成任务拆分和结果聚合。项目方在DeepSeek V4系列模型上完成内部测试,称这套异构方案实现性价比翻倍,业务运营成本下降四成以上。这不是类脑芯片替代GPU,而是根据任务特性拆分负载。不同计算任务对带宽、访存、矩阵运算需求不同,显存、片上存储、DDR、NVMe之间的硬件边界正在被重新定义。
存储市场的需求变化随之而来,但不必过度放大。据券商引用闪存市场测算,70B级别模型场景下,上下文从1K拉长到128K,单请求KV缓存占用会上百倍增长。推理业务带动企业级SSD、CXL内存需求提升。闪存只能作为补充,无法取代HBM。SSD存在写入放大、寿命损耗、数据一致性等问题,KV缓存频繁写入淘汰会加剧盘体损耗,跨节点共享还需要处理故障恢复。企业级SSD在全球NAND位元出货占比持续走高,代表内存分层架构逐步落地,不等于存储底层架构彻底更迭。
DeepSeek版本迭代和定价调整,藏着厂商的运营考量。9月10日至14日,V4-Pro调用路由逐步切向V4.1-Flash,官方没有宣布V4-Pro下线。峰谷定价叠加缓存分级计费,倒逼开发者优化调用习惯。固定不变的系统提示词,依靠服务端缓存复用就能享受低价。频繁变动的对话内容无法命中缓存,需要正常计费。厂商成本下降,一部分来自模型架构压缩,另一部分靠提升业务整体缓存命中率。
现实情况是,降价的仅限缓存命中的请求,未命中部分的定价几乎没有变化。市场上经常出现推理成本持续腰斩的判断,这个看法偏理想化。大模型能力还在持续迭代,成本结构正在发生明显转变。训练比拼峰值算力与硬件规模,推理比拼显存利用率、带宽效率、延迟水平与缓存复用率。
国内大模型调用规模爆发,放大了这套优化逻辑的价值。国家数据局披露,截至2026年3月底国内token日均调用量超过140万亿,对比2024年初的1000亿增幅超千倍。中国算力规模仍在追赶阶段,调用量的爆发会继续放大精细化调度的价值。巨大调用体量不等于模型智能同步提升,但意味着海量预计算、缓存读写与数据淘汰操作。算力竞争的观察维度,不再只局限于堆叠显卡,内存调度、互联传输和缓存复用这类精细化运营的权重正在持续上升。
看一家AI基础设施公司的真实运营水平,月底账单比跑分榜单更有参考意义。缓存命中占比、跨介质数据搬运次数、长会话和新建会话之间的价差、不同硬件任务适配效果、路由异常后的系统纠错能力,都是观察窗口。
显存是底座,带宽是传输通道,KV缓存就是持续流转的中间数据。压缩单token缓存体积只是优化的起点,未来基础设施竞争会慢慢脱离单纯的参数竞赛。能做到缓存高效复用、分层存储调度、算力动态分配的团队,才有机会把大模型从可运行的demo,打磨成稳定可控、成本可预测的线上服务。
本文仅作科技产业观察,不构成硬件采购与投资建议。
#头条精选-薪火计划#